MENU

YANSとは

YANSとは,Young Researcher Association for NLP Studiesの頭文字に由来する名称です. 言語処理学会では,若手支援事業として「言語処理若手シンポジウム(YANS)」と「YANS懇」を開催しています. これらの活動を通して,自然言語処理および周辺技術に携わる若手のネットワーク構築や研究推進に取り組んでいます.

新着情報

Xでも情報を発信しています. YANSアカウントはこちら

YANSにおけるアンチハラスメントポリシーを公開しています.

委員長

  • 赤間 怜奈 (東北大/国語研)
  • 渡邉 研斗 (産総研)

顧問

  • 佐藤 元紀 (Sakana AI)

委員

  • 大井 聖也 (科学大)
  • 大鹿 雅史 (名大)
  • 大葉 大輔 (科学大)
  • 尾崎 大晟 (大阪公大/東大/松尾研究所)
  • 加藤 祥太 (京大/産総研)
  • 亀井 遼平 (東北大)
  • 鴨田 豪 (総研大/国語研)
  • 川原田 将之 (サイバーエージェント/科学大/産総研)
  • 木山 朔 (一橋大)
  • 小林 滉河 (SB Intuitions/JAIST)
  • 芝原 隆善 (ELYZA)
  • 田屋 侑希 (中外製薬/お茶大)
  • 坪倉 和哉 (愛知県立大)
  • 新妻 巧朗 (朝日新聞社)
  • 長谷山 優菜 (北大)
  • 林 和樹 (NAIST)
  • 福地 成彦 (SB Intuitions)
  • 村上 夏輝 (パナソニック コネクト/お茶大)
  • 森下 睦 (フューチャー)

理事

  • 梶原 智之 (愛媛大/阪大)

秘書

  • 磯部 順子 (理研)

第21回言語処理若手シンポジウム(YANS2026) 開催報告

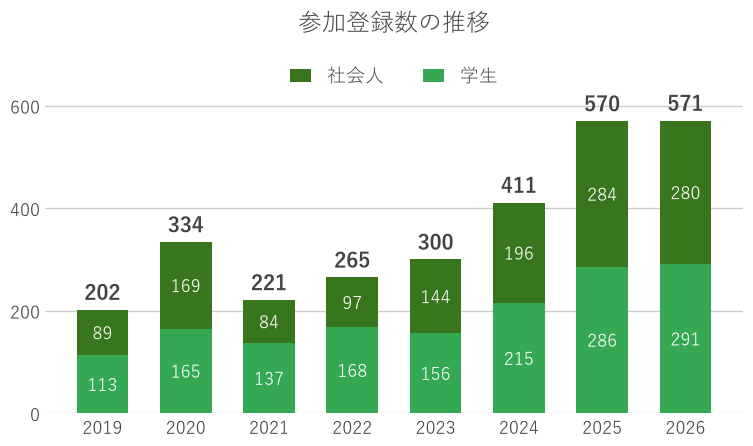
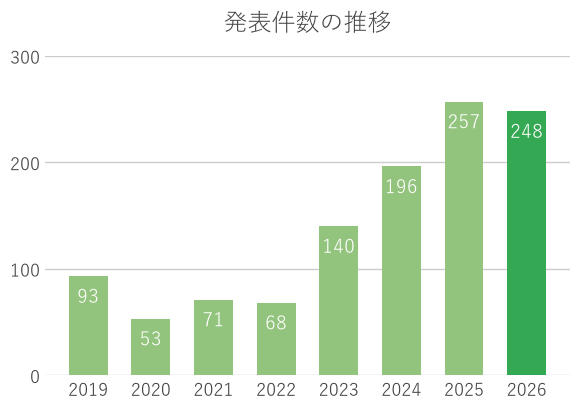
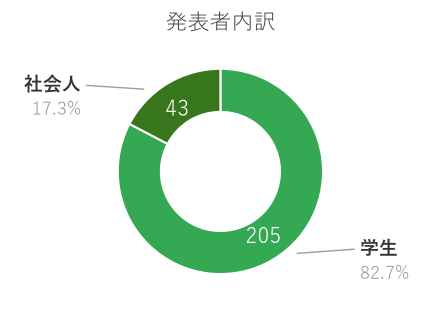
2026年8月16日(日)〜18日(火),仙台国際センターにて第21回言語処理若手シンポジウム(YANS2026)を開催しました. 今年度は過去最多の571名の参加(学生291名,社会人280名)と248件の発表(学生205件,社会人43件),37社のスポンサーの皆様をむかえ,今年も大盛況でした. ご参加いただいた皆様,ご支援いただいた皆様,どうもありがとうございました.

本シンポジウムでは,優秀な研究発表に対してデモ賞,奨励賞,スポンサー賞を授与しました.奨励賞はこれから始まる,または始まったばかりの研究を奨励することを主旨とするものであり,現時点の研究の完成度よりもアイデアの面白さ,及び新規性や発展性への期待を重視します.奨励賞およびデモ賞の選考は参加者による投票をもとに,最終的には表彰担当者による合議によって奨励賞は22件,デモ賞は2件を選出しました.スポンサー賞は産学交流の一環として各スポンサー独自の視点から26件の受賞者を選出していただきました.いずれの賞も受賞者は筆頭著者のみとなります.

今年のチュートリアルでは,株式会社豊田中央研究所の長屋隆之氏に「現場から世界標準へ:QRコード開発に学ぶ『読める』の設計原理」を,株式会社Preferred Networks・Matlantis株式会社の岡野原大輔氏 に「言語モデルの70年:シャノンから大規模言語モデルへ」をご講演いただきました.また,招待ポスターセッションでは自然言語処理や関連分野でご活躍なさっている気鋭の若手研究者/技術者21名をお招きし,これまでのご自身の研究についてポスター発表をしていただきました.

シンポジウム1日目の幕開けとして分野交流ハッカソンが開催されました. 本ハッカソンでは,幅広い分野の学生・社会人と広く交流することを目的として,citation hallucination(引用ハルシネーション)をテーマに開催されました.具体的には,引用文脈と引用先論文情報から,その引用が妥当か不適切かの判定を行い,手法でグループを分け独自モデル部門(OMD)と事例設計部門(ICL)の2部門のハッカソンが開催されました.ハッカソンには97名が参加し,各部門8チームずつ,計16チームが取り組みました. 本会議2日目に受賞チームによる最終成果発表が行われ,優秀賞,審査員特別賞,YANS委員特別賞が贈られました.

シンポジウムの様子

1日目(2026/8/16)

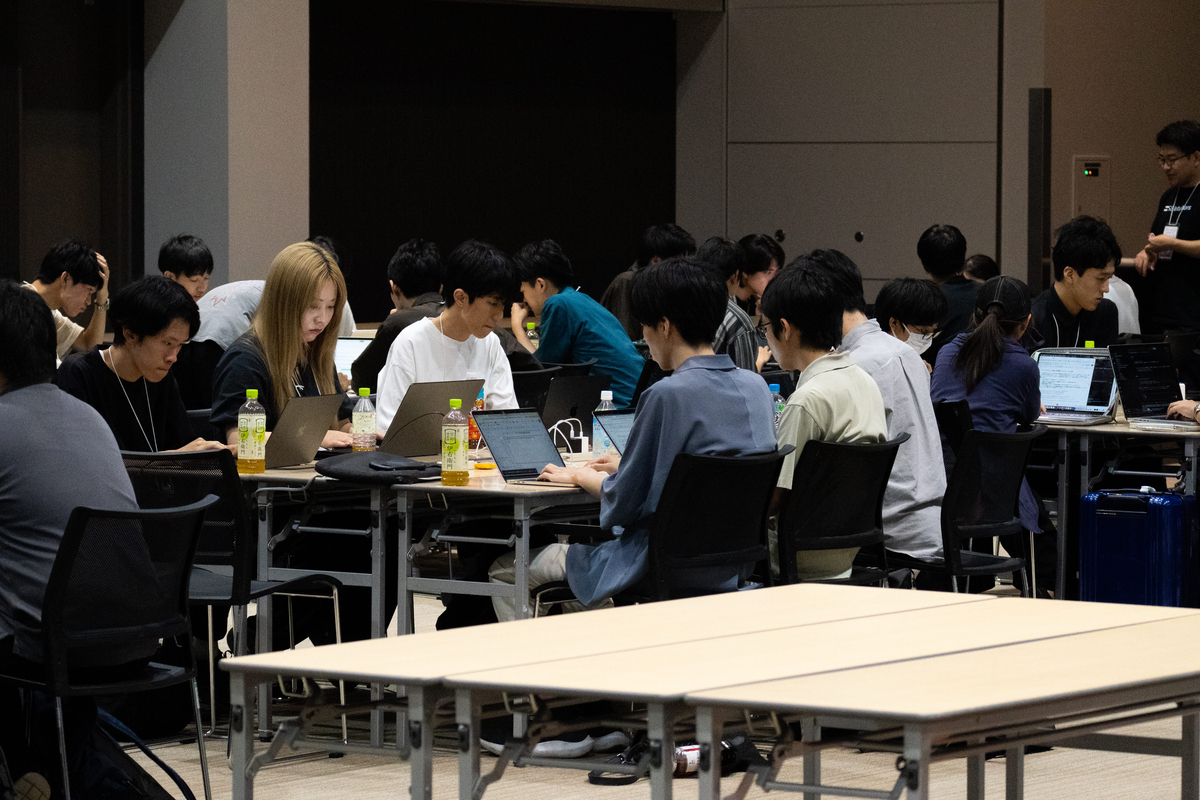
シンポジウム1日目には分野交流ハッカソンが開催されました. 引用ハルシネーションを題材とした引用の妥当性を予測し,独自モデル部門(OMD)と事例設計部門(ICL)に分かれてハッカソンを行いました. OMD部門では,推論時に大規模言語モデル(LLM)を使わずに引用の妥当性を判定,ICL部門では,大規模言語モデル(LLM)に少数の事例を与えて引用の妥当性を判定します. 国語研の横井祥さん,SB Intuitionsの品川政太朗さん,Preferred Networksの今城健太郎さんの豪華三銃士をお招きし,アドバイスや評価をしていただきました. ハッカソン詳細についてはこちらを参照ください.

ハッカソン会場の様子
もくもくと開発を進める参加者たち
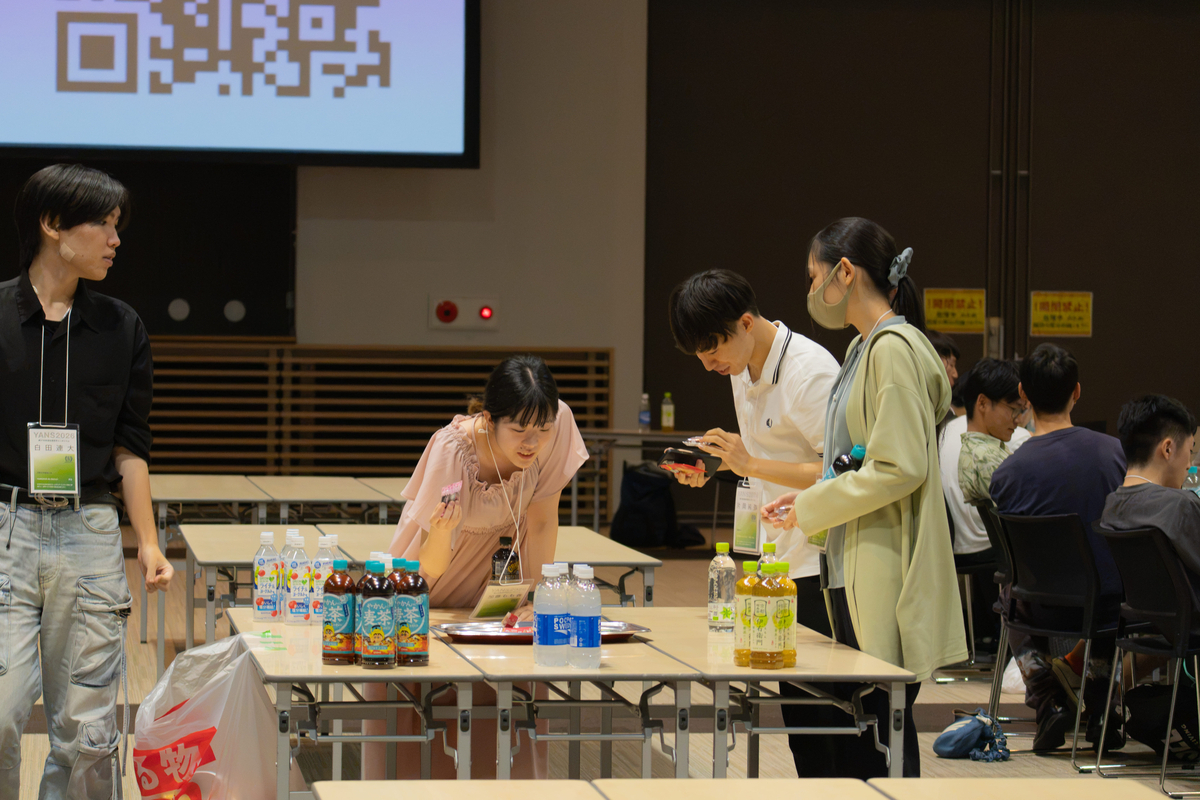
栄養補給
お菓子と飲み物で栄養補給
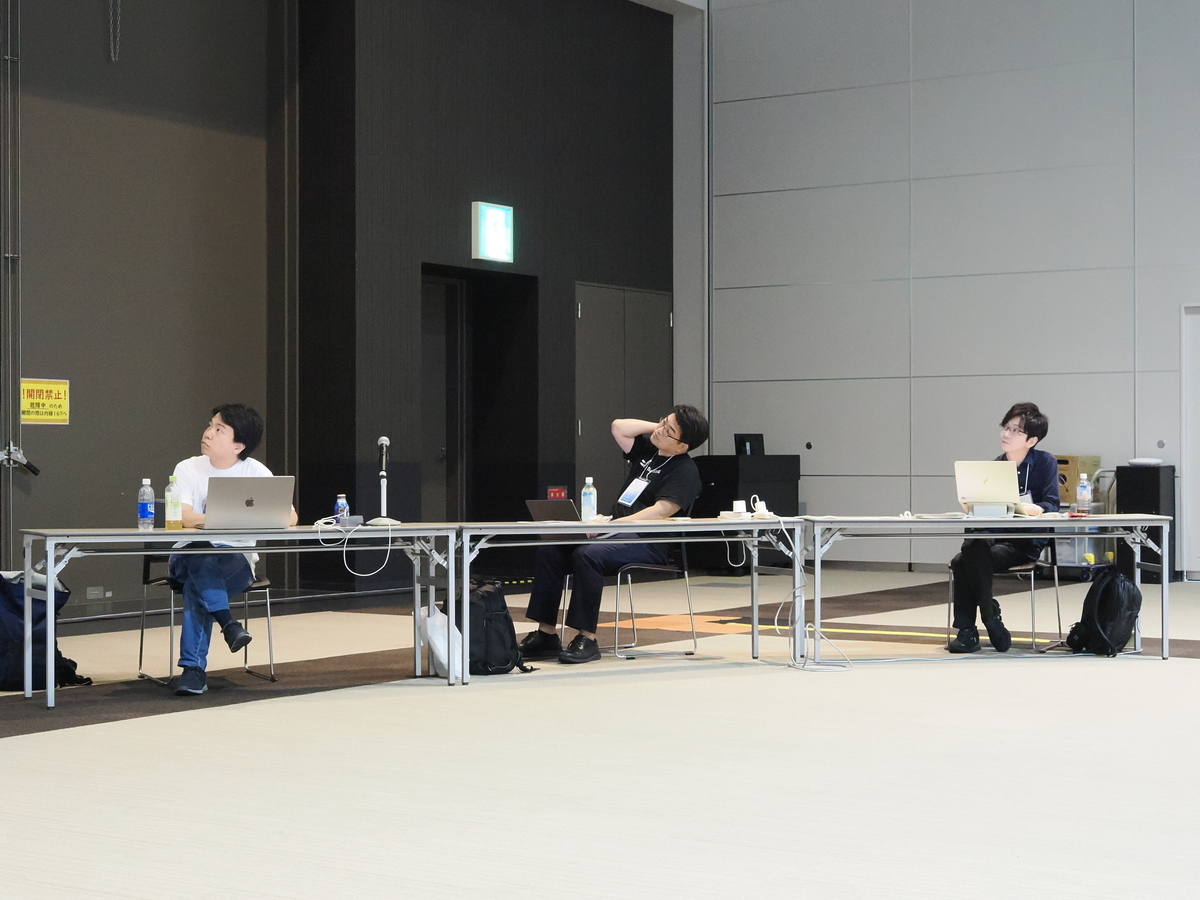
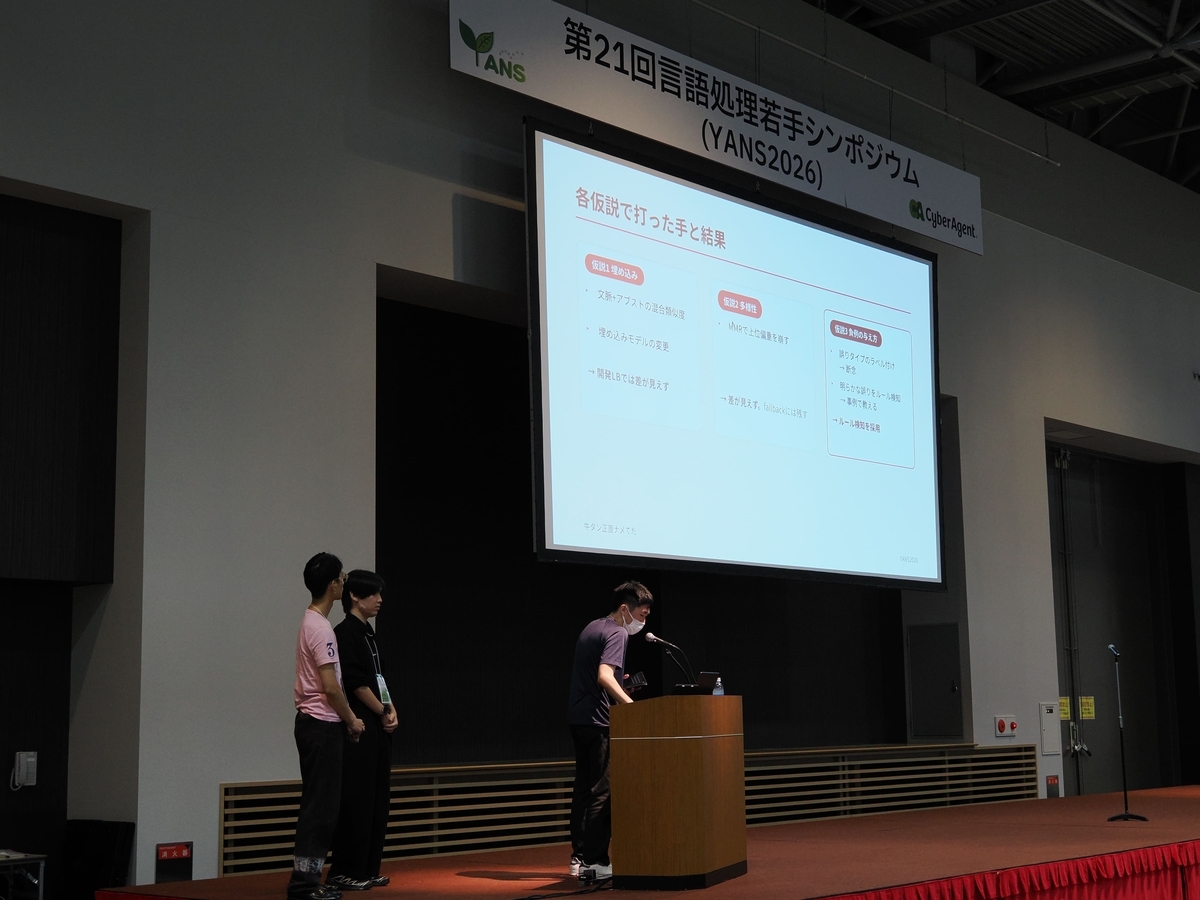
成果発表の様子
成果発表の様子
特別審査員
成果発表に聞き入る特別審査員の御三方!

2日目(2026/8/17)

今年のシンポジウムは571名と多くの方々にご参加いただきました. 株式会社豊田中央研究所の長屋隆之さんによるチュートリアルやポスター発表に加え,カジュアル交流会やスポンサーセッション,ナイトセッションなど多くの企画が行われました!

会場の様子
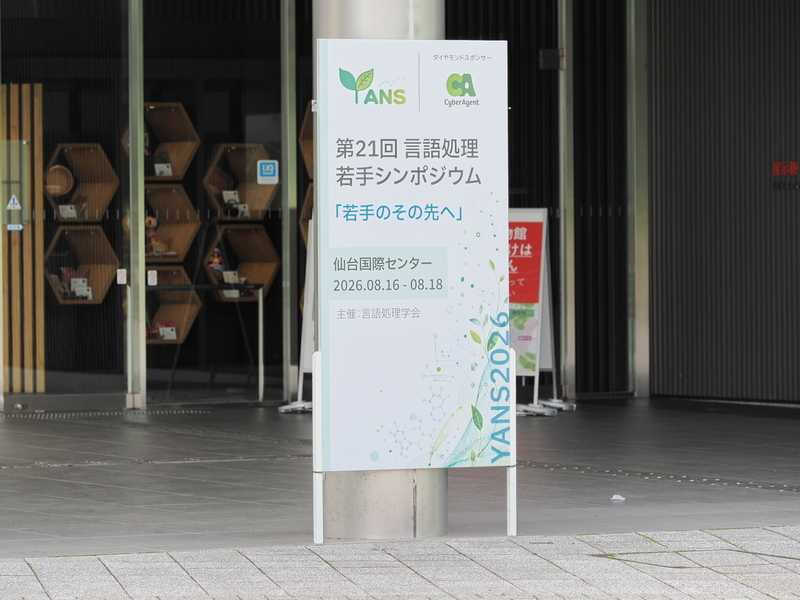
今年も目を引く看板
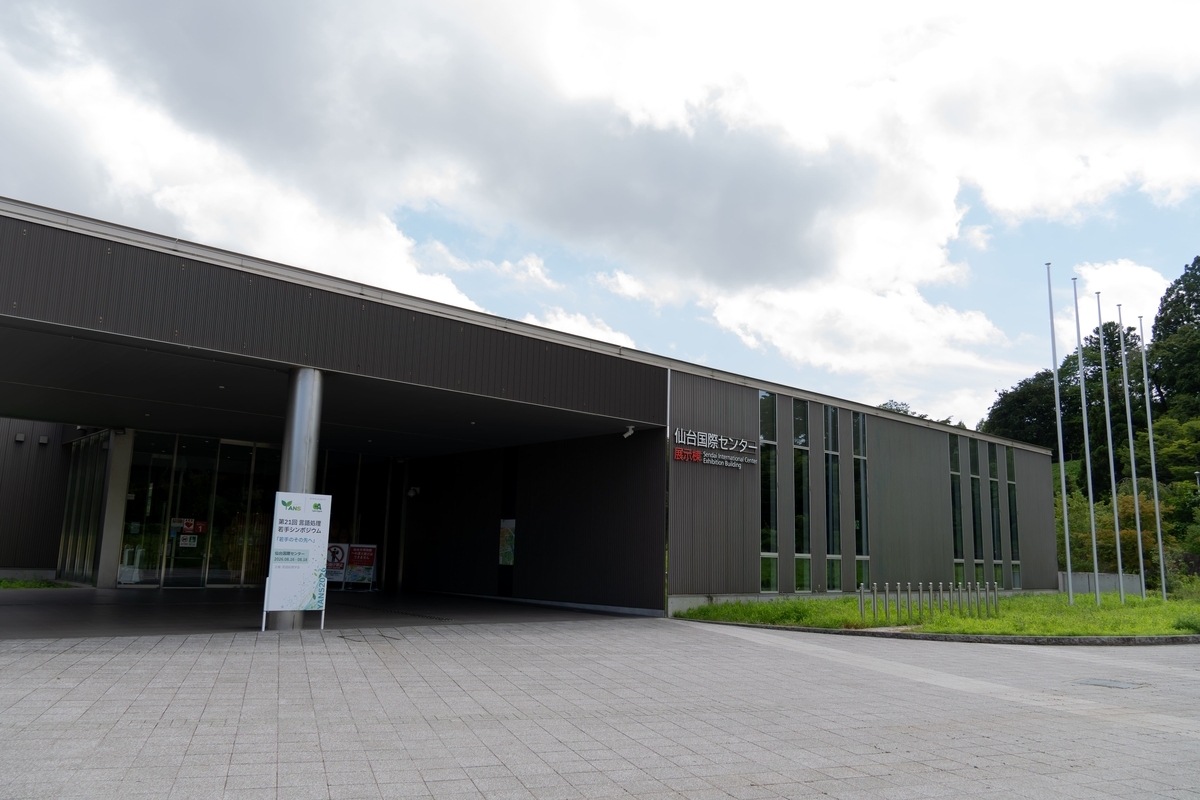
仙台国際センターで開催
緑豊かな仙台国際センターで開催
会場の様子
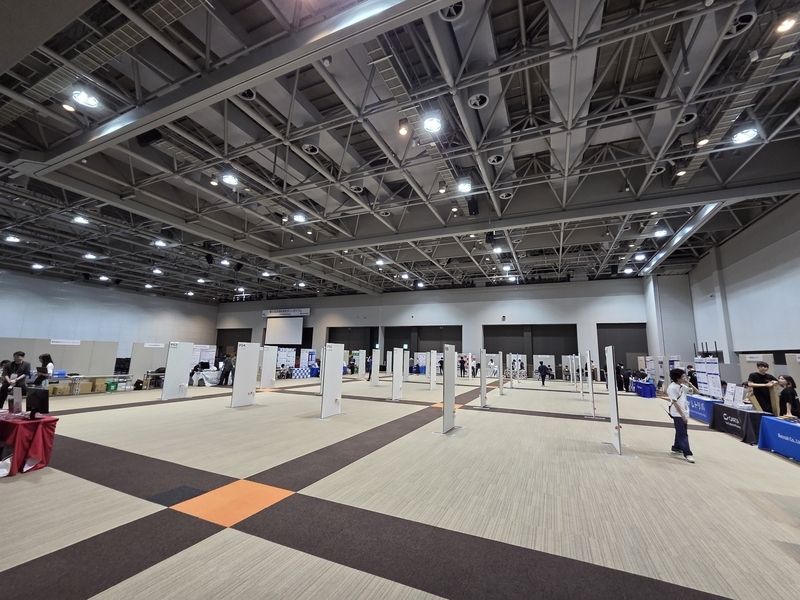
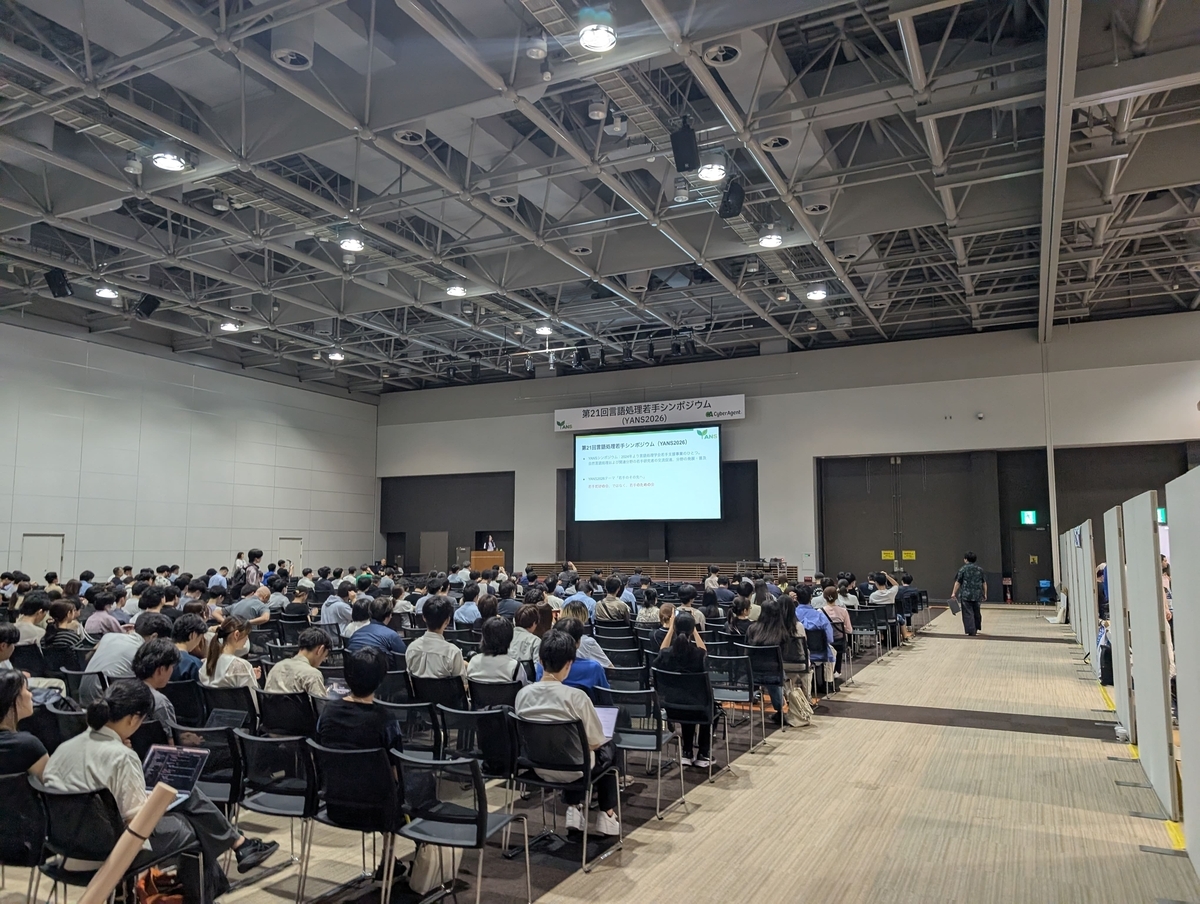
とても広くて快適な会場
会場の様子
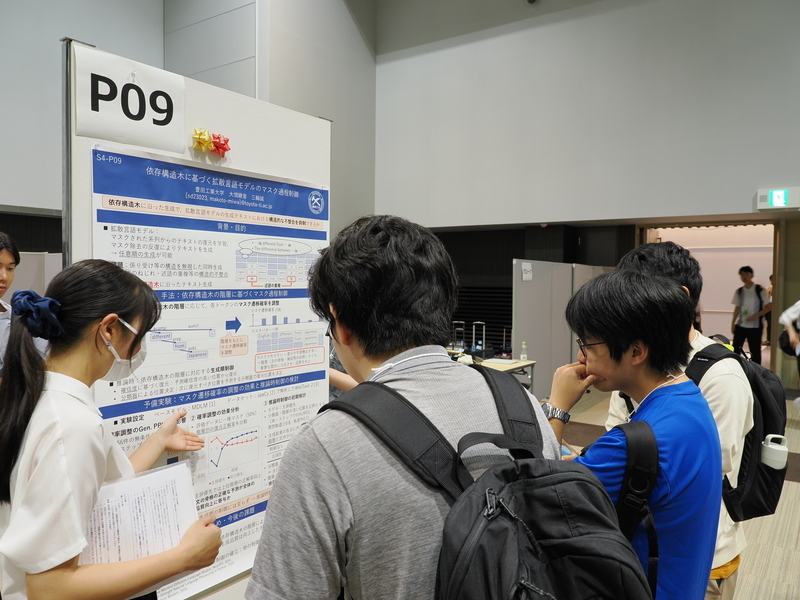
ポスター会場も広々
開幕
YANS開幕!
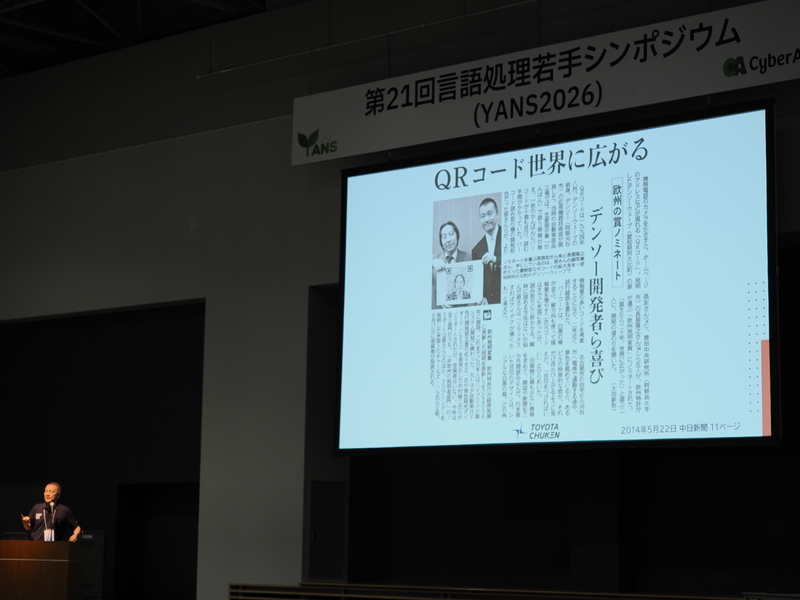
長屋隆之さんによるチュートリアル
長屋 隆之さんによるチュートリアル
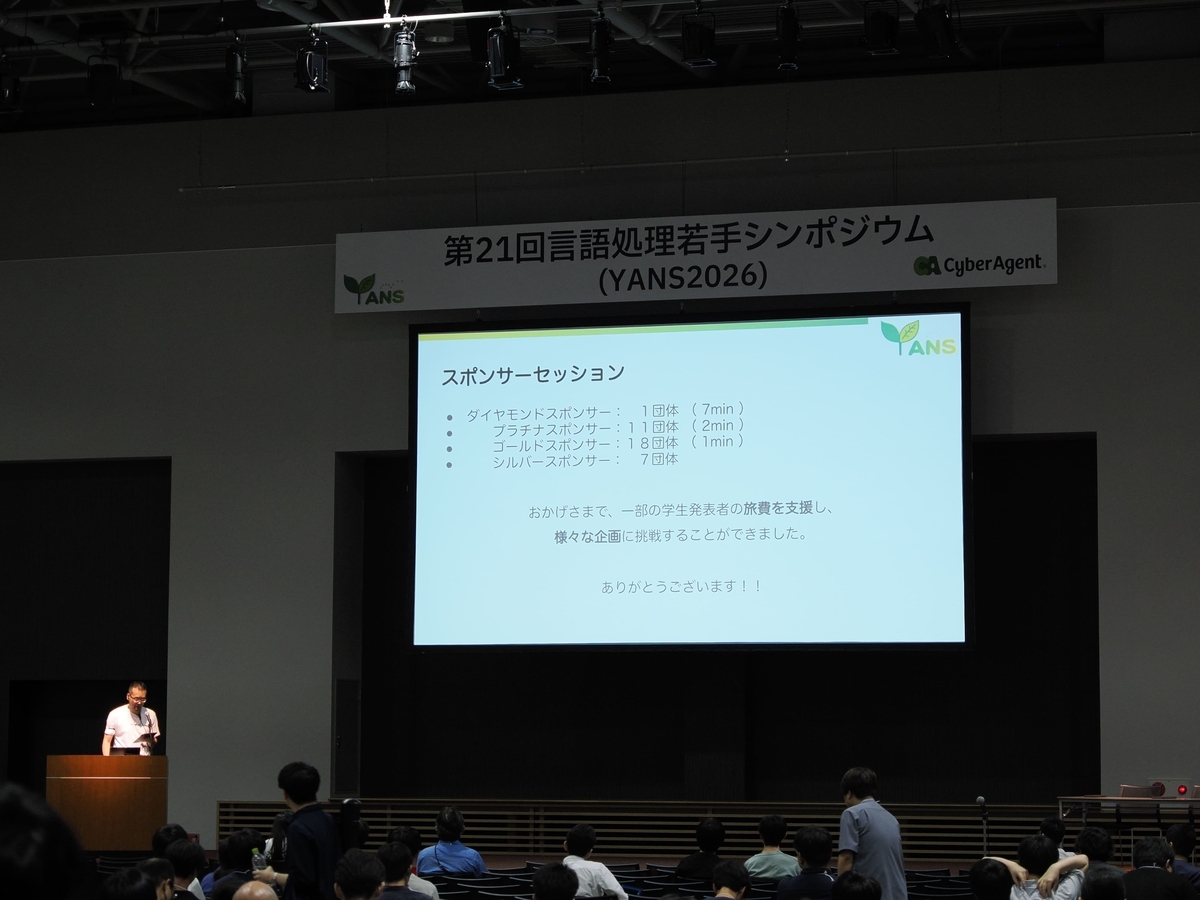
スポンサーセッション
スポンサーセッション
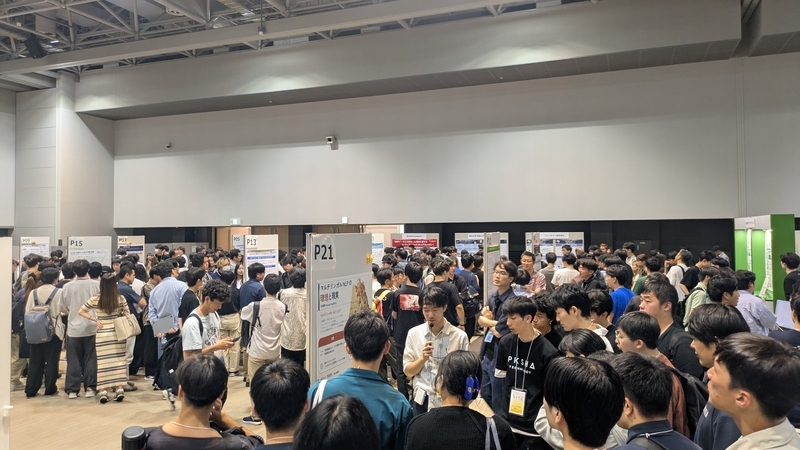
ポスターセッションの様子
大賑わいのポスターセッション
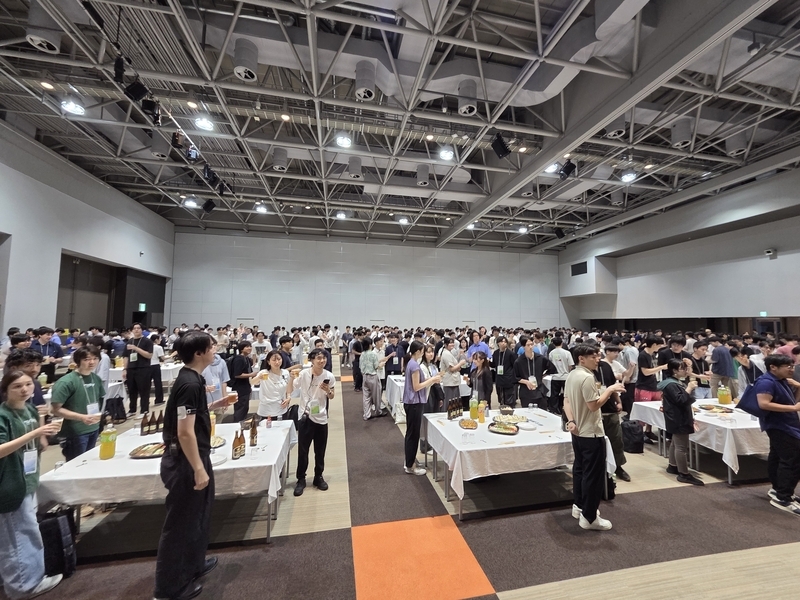
ナイトセッションの様子
ナイトセッション!
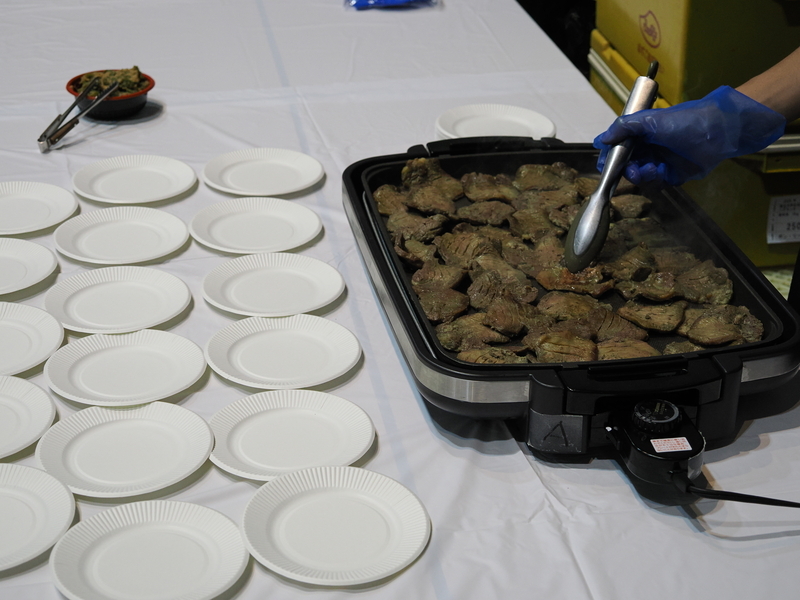
ナイトセッションの様子
牛タンが振る舞われました!

3日目(2026/8/18)

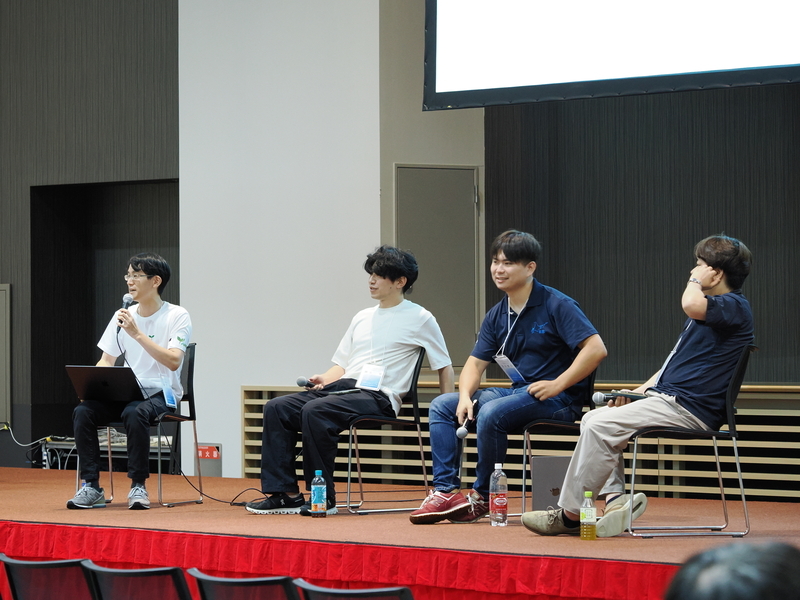
ハッカソンの開催報告,株式会社Preferred Networks・Matlantis株式会社の岡野原さんによるチュートリアル,招待ポスターセッション,特別企画セッションと面白いセッションが盛りだくさんでした. 招待ポスターセッションでは,自然言語処理や関連分野でご活躍なさっている気鋭の若手研究者/技術者の方々にご自身の研究について発表していただきました. 特別企画セッションでは,「キャリアの決め手 〜選択と分岐点〜」をトークテーマに,多様な経歴を持つ若手・中堅の研究者/技術者によるパネルディスカッションを行いました.進学,就職,転職,研究テーマの選択など,人生の節目で訪れたさまざまな転機にそれぞれがどう向き合ってきたのかを,森下 睦 さん(フューチャー株式会社)の司会のもと,パネラーの皆さんに語っていただきました.

パネラー(五十音順)
- 勝又 智 氏(株式会社レトリバ/東京科学大学)
- 坂井 優介 氏(奈良先端科学技術大学院大学)
- 三田 雅人 氏(株式会社リクルート/東京大学)

ハッカソン報告会
ハッカソン報告会
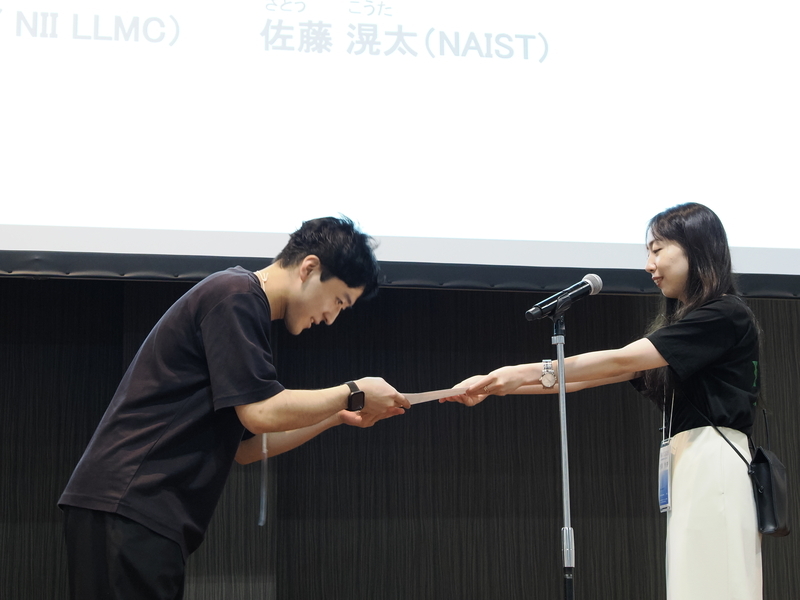
ハッカソン賞状の授与
ハッカソンの賞状が授与されました
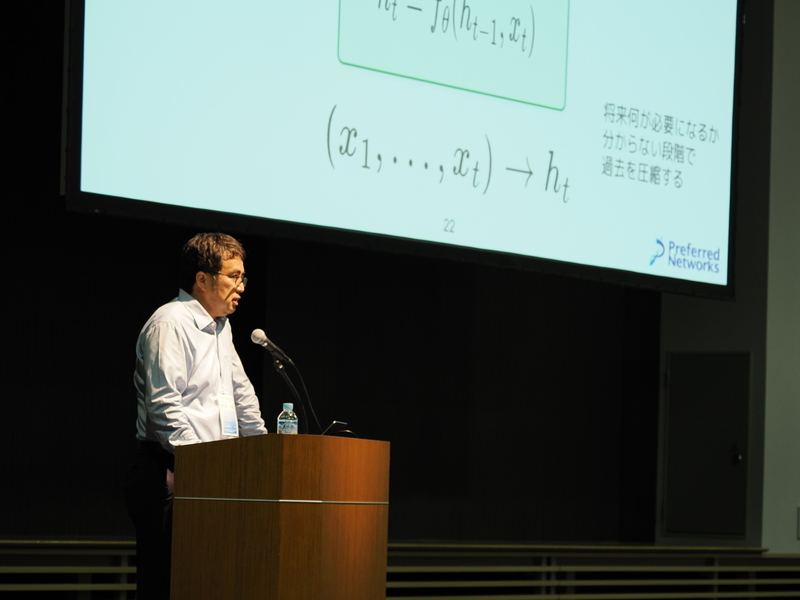
岡野原大輔さんによるチュートリアル
岡野原大輔さんによるチュートリアル
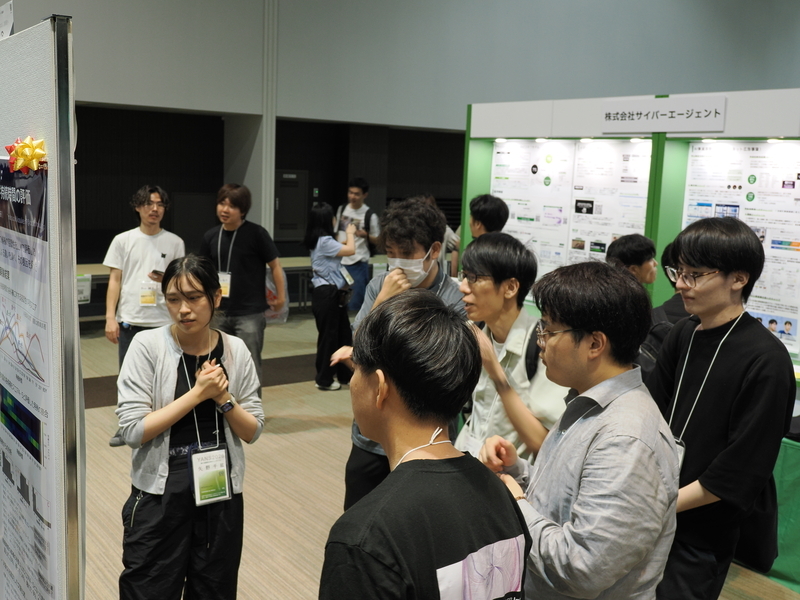
ポスターセッション②
2日目のポスターセッションも活発な議論が
招待ポスターの様子
招待ポスターも大盛り上がりでした!
特別企画セッションの様子
特別企画セッション
クロージングの様子
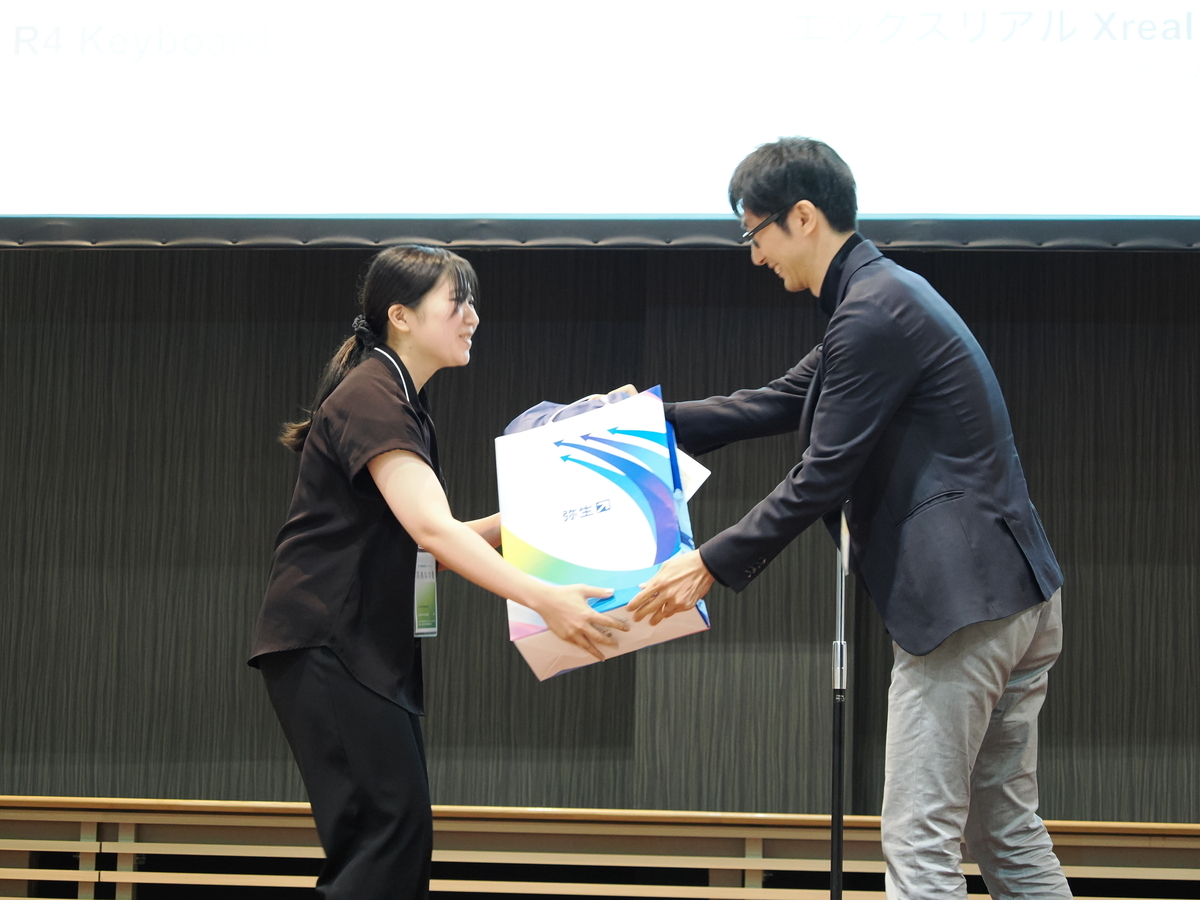
スポンサー賞の副賞発表に歓声
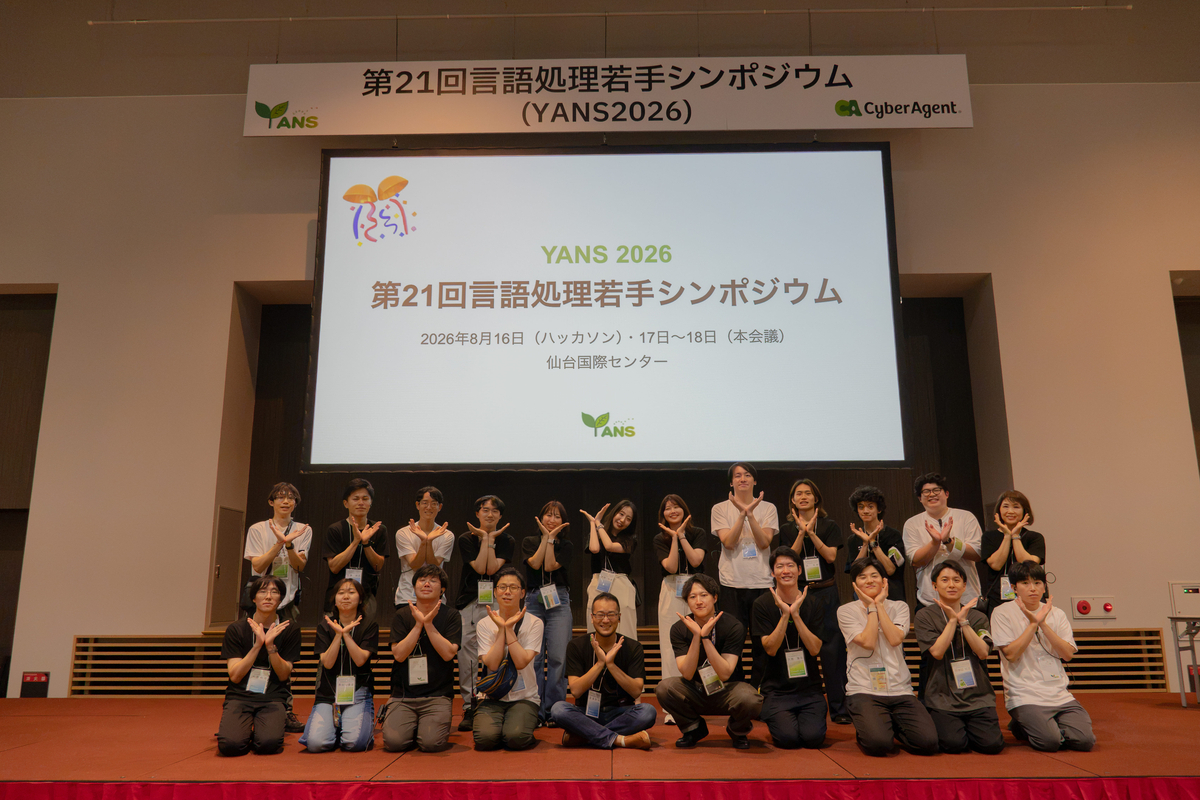
委員の集合写真
委員で集合(YANSポーズ)

統計データ

参加登録者数の推移

571名と数多くの方にご参加いただきました.

参加登録者数の推移
参加登録者数の推移

発表件数の推移

今年は248件の発表を募集しました.

発表件数の推移
発表件数の推移

発表者の内訳

248件の発表のうち,学生は205件(全体の約8割),社会人は43件(全体の約2割)の発表がありました.

発表者の内訳
発表者の内訳

発表資料等

オープニング・クロージング

オープニング資料

クロージング資料

招待ポスターセッション

タイトル 発表者 資料
計算言語学者としてなぜ言語創発に取り組むのか?これからどうしたいのか? 上田 亮 氏(国立情報学研究所) -
地図と言葉のクロニクル 大内 啓樹 氏(奈良先端科学技術大学院大学) 資料
物語をつくる・届ける企業でAIエンジニアができること 大竹 孝樹 氏(講談社) -
言語モデルがAGIの基盤になるなんて 賀澤 秀人 氏(Google DeepMind) -
言語処理学会年次大会の歩き方 – 参加者兼企画者として 金山 博 氏(日本アイ・ビー・エム 東京基礎研究所) 資料
コードを介した文書画像の理解と生成 斉藤 いつみ 氏(東北大学) 資料
バオバブとは何か 相良 美織 氏(バオバブ) 資料
クリエイターを支える言語処理技術 佐藤 浩輔 氏(バンダイナムコ研究所) 資料
NLPから専門領域AIへの展開 進藤 裕之 氏(MatBrain) 資料
博士課程ってどんなところ?:自由すぎる研究生活の楽しみ方 関 健太郎 氏(東京大学) 資料
ニューラル言語モデルとの歩み 高瀬 翔 氏(サイバーエージェント) 資料
自動運転スタートアップでの挑戦 ― NLPからフィジカルAIへ 寺西 裕紀 氏(Turing) 資料
国産LLMをなぜ作るのか〜一研究者の立場から〜 西田 光甫 氏(NTT 人間情報研究所) 資料
研究留学への不安を少しでも減らすために 芳賀 あかり 氏(奈良先端科学技術大学院大学) -
ChatGPTが無かった時代の博士課程 平岡 達也 氏(MBZUAI) 資料
狭くて広い,企業での研究活動 本多 右京 氏(サイバーエージェント) -
好奇心のおもむくままに:アカデミアから企業へ、テキストから音声へ 水本 智也 氏(SB Intuitions) -
LLMは最強のラップバトルMCになり得るか? 三林 亮太 氏(神戸大学 国際文化学研究科) 資料
君たちは対話システム界隈でどう生きていくか 吉田 快 氏(IVRy) 資料
言語モデルと人間を比較・対照するということ 吉田 遼 氏(東京大学) 資料
マルチリンガルNLPの理想と現実 李 凌寒 氏(Google DeepMind) -

ハッカソン

ハッカソンの概要

OMD部門

チーム名 発表資料
チーム1 (国際センタに牛タンを) 資料
チーム2 (牛タンと、コーヒー。) 資料
チーム3 (ずんだシェイクトール) 資料
チーム4 (まごたち) 資料
チーム5 (ほうじ茶) 資料
チーム6 (冷やし牛タン) 資料
チーム7 (ベストベースライン) 資料
チーム8 (ずんだシェイカーズ) 資料

ICL部門

チーム名 発表資料
チームa (温泉・挑戦) 資料
チームb (ラングドシャモデル) 資料
チームc (牛タン正直ナメてた) 資料
チームd (マーボー焼きそば) 資料
チームe (Eagles) 資料
チームf (健康第一) 資料
チームg (牛タン難民) 資料
チームh (チーム若葉) 資料

参加報告ブログの紹介

今回のシンポジウムにご参加いただいた多くの方からも参加報告ブログを書いていただきました. ぜひ,学生や企業の方など様々な参加者の皆さまが本シンポジウムで感じた生の感想やレポートもあわせてご覧ください.

スポンサー企業の皆様による参加報告

buildersbox.corp-sansan.com

zenn.dev

tech-blog.abeja.asia

www.m3tech.blog

moneyforward-dev.jp

zenn.dev

tech-blog.yayoi-kk.co.jp

hack.nikkei.com

voice.pkshatech.com

参加者の皆様による参加報告

green-caviar.dev

zenn.dev

aitech.ac.jp

note.com

qiita.com

zenn.dev

https://researchmap.jp/blogs/blog_entries/view/1200776/723679bf961f4541e256b9a43ee8385c?frame_id=2079707researchmap.jp

zenn.dev

zenn.dev

note.com

受賞者

本シンポジウムでは全248件の発表に対して,2件のデモ賞,22件の奨励賞,26件のスポンサー賞が授与されました. また分野交流ハッカソンでは,OMD部門とICL部門それぞれにおいて優秀賞,審査員特別賞,YANS委員特別賞が授与されました.

デモ賞 (対象23件中2件)

  • 北海道アイヌ語に対する音声合成モデルの学習と評価
    ◯花田 佳文 (東大), 中田 琉稀 (東大), 林 克彦 (東大)
  • テキストの意味的ソート・順序制約付き意味的ソート
    ◯福地 成彦 (SB Intuitions)

奨励賞 (対象231件中22件)

  • LLMは未知言語のコードを何語で考えているか
    ◯森部 七海 (本女), 西潟 優羽 (本女), 宮田 侑佳 (本女), 倉光 君郎 (本女)
  • VLMは複雑な表画像をどこまで読めるか? ― 行数・列数・セル結合を制御した表構造認識の性能分析 ―
    ◯會田 勇斗 (ストックマーク), 陳 実 (ストックマーク), 森長 誠 (ストックマーク), 田中 翔平 (ストックマーク), 有馬 幸介 (ストックマーク)
  • CLIPにおける埋め込みのノルムは本当に捨ててよいのか?
    ◯佐藤 祥太 (一橋), 木山 朔 (一橋), 平澤 寅庄 (一橋), 小町 守 (一橋)
  • タスクベクトルは説明可能かつ制御可能な成分に線型分解できる
    ◯堀場 幸也 (慶大), 趙 羽風 (理研/東北大), 矢向 高弘 (慶大)
  • LLM最終隠れ層での急激な変化の要因と影響
    ◯柴田 圭悟 (東北大), 小林 颯介 (東北大), 高瀬 翔 (東北大), 矢野 一樹 (東北大), リュウ センペイ (SB Intuitions), 鈴木 潤 (東北大)
  • LLMは感情強度の高いエピソードを優先して記憶するのか — 獲得・保持と想起前後の内部表現
    ◯大西 直 (JAIST/松尾研究所), 北島 祥平 (JAIST), 手塚 陽大 (JAIST), 井之上 直也 (JAIST)
  • 小学校漢字学習におけるLLM生成物語の「違和感」の類型化とLLM間の比較
    ◯吉村 賢人 (大教大), 高見 享佑 (大教大), 古橋 萌々香 (東北大/NII LLMC), 中山 功太 (NII LLMC), 児玉 貴志 (NII LLMC)
  • LLM-as-a-Judgeにおけるリッカート評価とランキング評価の比較分析
    ◯松田 翔汰 (東北大), 柴田 圭悟 (東北大), 津田 純花 (東北大), 有川 透矢 (東北大), クェク ヨン シン (東北大), 池田 航 (東北大), 齋藤 由佳 (東北大), 種口 暁人 (東北大), 松田 陵佑 (東北大), 赤間 怜奈 (東北大/理研/国語研), 鈴木 潤 (東北大/理研/NII LLMC)
  • 北海道アイヌ語に対する音声合成モデルの学習と評価
    ◯花田 佳文 (東大), 中田 琉稀 (東大), 林 克彦 (東大)
  • ギャルは口調だけで成らず:当事者インタビューに基づく対話AIペルソナの設計と実装
    ◯池上 桃花 (駒大/産総研), 栗林 雅希 (早大), 加藤 卓哉 (駒大), 大西 正輝 (産総研), 平井 辰典 (駒大)
  • 階層的な質問による解釈可能なテキスト埋め込み
    ◯小田 康平 (JAIST), 荘 博閔 (東芝)
  • LLM推論における内部表現を用いたヒント妥当性の推定と選択的介入
    ◯峯村 祥生 (東大), 浅野 輝 (東大), 馬場 雪乃 (東大)
  • 単体複体を用いた言語モデルの出力空間の幾何的解釈
    ◯石峯 拓海 (東大/国語研), 日野 英逸 (統数研/総研大), 横井 祥 (国語研/東北大学/理研/総研大)
  • 音声合成モデルのパラメータ演算による任意話者の声質での方言合成
    ◯三森 俊祐 (SB Int/早大), 水本 智也 (SB Int), 藤田 雄介 (SB Int)
  • nanochat-jp: 小規模日本語特化言語モデル統合研究基盤
    ◯工藤 慧音 (東北大/理研), 山口 健史 (理研), 坂口 慶祐 (東北大/理研)
  • インターネットラジオを用いた日本語諸方言音声コーパスの半自動構築
    ◯中島 未唯 (慶大), 佐藤 なな子 (慶大), 高道 慎之介 (慶大/東大)
  • 大規模言語モデルにおける文内Attentionメカニズムの分析
    ◯鴨田 豪 (総研大/国語研), 窪田 悠介 (総研大/国語研), 横井 祥 (総研大/国語研/東北大/理研)
  • 対話(たいわ)におけるLLMの漢字(かんじ)読(よ)み能力(のうりょく)の評価(ひょうか)
    ◯青野 広太郎 (SB Int), 高山 隼矢 (SB Int)
  • 元データの評価観点を保持した制御可能なQAデータ拡張
    ◯小島 亮 (豊田工大), 三輪 誠 (豊田工大)
  • サプライザルは表記選好と逆相関する
    ◯山口 美咲 (東大), 三田 雅人 (東大), 磯野 真之介 (国語研), 大関 洋平 (東大/NII)
  • LLM-as-a-Judgeにおける絶対評価と相対評価の整合性はスコア帯でどのように変わるか?
    ◯山下 伊織 (一橋大), 木山 朔 (一橋大), 伊藤 大陽 (一橋大), 小町 守 (一橋大)
  • 形容詞が導く文化バイアス
    ◯福井 優那 (金大), 平尾 努 (金大), 高村 大也 (産総研)

スポンサー賞

株式会社サイバーエージェント賞

  • 生成過程の段階的分解によるフロー言語モデルの品質改善
    ◯大塚 雄貴 (科学大), 大葉 大輔 (科学大), 岡崎 直観 (科学大/産総研/NII LLMC)
    【受賞理由】ニューラル言語モデルでは自己回帰モデルが主流であり、それ以外の生成方式の探索は重要な課題です。本研究はフロー言語モデルについて生成過程を多段階に分解する複数の戦略を提案、実験しており、今後の発展が期待できることから、スポンサー賞に選定いたしました。
  • パラメータ空間の幾何構造から見るタスク算術の失敗
    ◯李 宰成 (総研大/国語研), 中石 海 (国語研/理研), 唐木田 亮 (国語研/理研/産総研/科学大), 横井 祥 (総研大/国語研/理研/東北大)
    【受賞理由】個々のタスクベクトルの和によるモデル構築は成功する一方、タスクを組み合わせて直接学習しようとした場合には失敗するという観測について、理論的に説明を提示しようとしている姿勢と、現状で得られている結果の興味深さからスポンサー賞に選定いたしました。

フューチャー株式会社賞

  • LLM-as-a-Judgeにおける絶対評価と相対評価の整合性はスコア帯でどのように変わるか?
    ◯山下 伊織 (一橋大), 木山 朔 (一橋大), 伊藤 大陽 (一橋大), 小町 守 (一橋大)
    【受賞理由】本研究は,LLM-as-a-Judgeの絶対・相対評価の不整合をスコア帯ごとに分析し,その要因を広く影響するものと局所的なものとに切り分けて示しました.当社でも業種の異なる多様な顧客向けの開発において,既存の自動評価指標では捉えきれない品質の評価にLLM-as-a-Judgeを用いる機会があり,スコアの解釈は運用上の重要な課題です.実務に直結する指針を与えた研究として,スポンサー賞に選定いたしました.

東北大学 言語AI研究センター賞

  • 進化戦略によるLLM最適化における破滅的忘却の抑制:GRPO由来パラメータマスクの導入
    ◯福田 創 (早大), 河原 大輔 (早大)
    【受賞理由】本研究は,当センターが注力するLLM構築に関する研究であり,GRPOで変化した座標にES更新を限定する着眼点が明快で,初期実験でも有望な結果が示されています.今後,複数seedや他ドメインで有効性が示されれば国際会議への採録も期待できる研究であり,研究テーマの一致度,手法の納得感,研究としての完成度のバランスが最も良い発表であると判断し,東北大学言語AI研究センターのスポンサー賞に選定しました.

株式会社Acompany賞

  • 入力テキストとのアライメントを提供するハルシネーションスパン検出手法
    ◯山田 美優 (科学大), 荒瀬 由紀 (科学大)
    【受賞理由】本研究は、生成文中のトークンをマスクし、入力文から当該内容をどの程度予測できるかを手がかりとしてハルシネーションを検出するという、着眼点に優れた手法を提案しています。特に、マスキングを単なる学習手法としてではなく、入力文と生成文の整合性を評価するための仕組みとして活用している点に独創性があります。さらに、ハルシネーションの検出と同時に入力文中の対応箇所を提示することで、判定結果の解釈可能性にもつなげています。ハルシネーション検出という重要な課題に対し、シンプルでありながら発展性のあるアイデアを提示している点を高く評価し、スポンサー賞を授与します。

Sansan株式会社賞

  • 損失曲面のSharpnessに着目した継続SFT初期値の探索
    ◯杉本 陽大 (東北大), 矢野 一樹 (東北大), 鈴木 潤 (東北大/理研/NII LLMC)
    【受賞理由】本研究は、継続SFTによる破滅的忘却に対し、損失曲面のSharpnessという観点からアプローチしたものです。継続SFTの前にSharpnessを低減する学習を加えるという着想が興味深く、モデルを用途に応じて継続的に学習・活用していく上でも重要なテーマだと感じました。 Sansanでも、公開モデルや社内の学習済みモデルに対して再度SFTを行う機会が多くあります。その際に生じる破滅的忘却に対する実用的な研究であり、今後の発展性を強く感じたことから、スポンサー賞に選定しました。

株式会社リクルート賞

  • LLMによるインタビューにおける深堀り質問展開戦略の比較・評価
    ◯土田 陸斗 (筑波大学), 園田 哲也 (筑波大学), 宇津呂 武仁 (筑波大学)
    【受賞理由】半構造化インタビューにおける深掘り判断とペルソナ抽出の設計は、弊社のHRプロダクトにおけるuser intake(採用担当者への候補者ヒアリング等)でも直面する課題と近い問題設定であり、既存手法との比較実験は設計改善への有益な示唆となりました。情報収集戦略そのものを評価する研究は希少であり、今後の発展を期待して本賞に選定しました。

SB Intuitions株式会社賞

  • 形容詞が導く文化バイアス
    ◯福井 優那 (金大), 平尾 努 (金大), 高村 大也 (産総研)
    【受賞理由】本研究では、Text-to-Imageモデルを対象に形容詞(e.g., traditional)が生成画像に及ぼす文化的な影響を調査しており、モデルごとに特定文化圏への偏りを持つなど興味深い分析結果を提示しています。 これは日本の文化に根ざした基盤モデルの開発に取り組む弊社にとっても重要な課題提起と知見であり、今後の発展を期待し、スポンサー賞に選定いたしました。

株式会社CARTA HOLDINGS賞

  • 元データの評価観点を保持した制御可能なQAデータ拡張
    ◯小島 亮 (豊田工大), 三輪 誠 (豊田工大)
    【受賞理由】本研究は、元のQAデータセットの評価観点・分布を保持したままデータ拡張する手法を提案しています。評価観点・分布という抽象度の高い概念を、QA特性としてスキーマ設計し、カテゴリ軸とLLM性能軸の2軸で綺麗に捉えています。カテゴリの分布はスキーマがダイレクトに効くイメージが持てますが、LLM性能軸への効果は自明でない中で実際に易化抑制に効いている点に面白みがありました。拡張手法も検証手法も巧く設計されている点がとても印象的で、スポンサー賞に選定しました。

株式会社レトリバ賞

  • 文化的に潜在化したメンタルヘルスリスクに対するLLM応答の安全性評価ベンチマークの構築
    ◯嵐 大樹 (奈良医大), 久田 祥平 (NAIST), 折茂 圭介 (Ubie), 太田 満久 (Ubie), 風間 正弘 (Ubie), 五十嵐 健史 (Ubie), 荒牧 英治 (NAIST)
    【受賞理由】本研究は、明示的な危機表現を伴わず文化的に潜在化するメンタルヘルスリスクに着目し、LLM応答の安全性を評価するベンチマークを構築したものです。人の生命・健康に関わる社会的重要性、危機が明示されない相談を対象とする学術的新規性、緻密な評価設計を高く評価しました。LLMの安全性向上を重視する弊社の取り組みにも合致する研究として、スポンサー賞に選定いたしました。

シェルパ・アンド・カンパニー株式会社賞

  • 牛舎内音声を用いた教師なし異常検知手法の検討
    ◯寺尾 瑠真 (愛県大), 坪倉 和哉 (愛県大), 神谷 咲月 (農総試), 小島 秀介 (農総試), 兒嶋 朋貴 (農研機構), 入部 百合絵 (愛県大)
    【受賞理由】本研究は、少人数で多頭数の家畜を管理する現場課題に対し、牛舎内音声による非接触型モニタリングを提案しています。約2,100時間に及ぶ実環境データを自ら収集し、鳴き声の抽出とアノテーション、環境音と鳴き声の幅広い分析を丹念に進めた点を高く評価しました。動物福祉と持続可能な畜産に資する取り組みが弊社の理念とも合致することから、シェルパ・アンド・カンパニー賞に選定しました。

株式会社エニトグループ賞

  • 出来事に基づく認知症介護者の自然文感情予測におけるLLMの比較評価
    ◯白川 桃子 (武蔵野大工), 佐々木 多希子 (武蔵野大工)
    【受賞理由】人は誰もが自分の正直な感情を言葉にできるわけではありません。本研究は認知症介護者が語りやすい「出来事」から感情を自然文で予測し、ACEのプレイブック更新をバッチ化することで個別事例への依存を避けるという独自の工夫を示しています。弊社が運営するマッチングサービスにおいても、うまく言葉にできない想いを汲み取る事は重要な事業課題であり、生の声からAIエージェントのコンテキストを育てるという発想に大きな可能性を感じました。インタビューデータを安易に拡張せず大切に扱われている姿勢も含め、実現場に深く寄り添った研究としてスポンサー賞に選定しました。

株式会社Preferred Networks賞

  • 事前学習コーパスの栄養成分表示
    ◯源 怜維 (早大/LLMC), 藤田 一颯 (早大/LLMC), 清丸 寛一 (LLMC), 小田 悠介 (LLMC), 児玉 貴志 (LLMC), 河原 大輔 (早大/LLMC)
    【受賞理由】LLMの事前学習コーパスはノイズが多く改良の余地が大きい一方、その規模ゆえに分析や前処理に取り組める組織は限られており、近年は知見が公開されることも少なくなっています。本研究は、事前学習コーパスの様々な組成を定量化する分析パイプラインを構築したもので、貴重な知見を提供しており、インタラクティブなデモも印象的でした。フルスクラッチで国産LLMを開発する弊社にとっても価値が高いと判断し、スポンサー賞に選定しました。

株式会社エクサウィザーズ賞

  • 前臨床期アルツハイマー病検出に向けた高齢者自由会話音声認識の検討
    ◯種村 圭師 (愛県大), 坪倉 和哉 (愛県大), 入部 百合絵 (愛県大), 北岡 教英 (豊橋技科大)
    【受賞理由】認知症が進行する前から認知機能の変化を捉え,備えることは社会的に極めて重要です.本研究は,その実現の鍵となる高齢者の自由会話音声認識に着目し,データ拡張や年齢推定とのマルチタスク学習による精度向上を試み,また認識誤りの詳細な分析を行っています.自由会話音声から認知機能を可視化するAIをグループ会社で提供する弊社にとって大変意義深い研究であり,今後の発展を期待して選定いたしました.

株式会社ELYZA賞

  • 異なる語彙を持つ LLM 間のオンポリシ蒸留
    ◯木村 優介 (JST/名大/同大), 駒水 孝裕 (名大), 波多野 賢治 (同大), 石川 佳治 (名大)
    【受賞理由】本研究は、異なる語彙を持つLLM間のOn-Policy Distillationにおいて、既存手法が共通するトークンに依存し、次トークン予測を直接指導しにくいという課題に取り組んでいます。生徒のTop-k候補をバイト列として捉え、教師・生徒のトークン確率を集約するByteTop-k OPDを提案しました。既存研究を踏まえつつ、語彙の違いをより直接的に扱う点を高く評価しました。実験では特にGSM8Kで既存法を上回る結果を示しています。モデルファミリーやトークナイザーを越えた蒸留は、モデル選択の自由度を高め、効率的なLLM開発につながる可能性があります。以上より、実用性と今後の発展性を評価し、ELYZA賞に選定しました。

Gen-AX株式会社賞

  • 音声対話における発話タイミング予測
    ◯大西 一誉 (奈良先端/理研/阪大), 大中 緋慧 (奈良先端/理研), 吉野 幸一郎 (奈良先端/理研/阪大/科学大)
    【受賞理由】音声AIの実運用では、わずかに早い発話開始が顧客への割り込みとなり、遅すぎる応答は不自然な沈黙を生みます。本研究では、発話開始までの近さを連続値として学習することで、従来手法が直接扱えなかった「いつ話すか」を高精度に予測しつつ、誤警報も抑えています。顧客の発話を尊重しながら自然さと応答性を両立するという弊社の課題に直結する成果として、スポンサー賞に選定させていただきました。

株式会社ABEJA賞

  • CLIPにおける埋め込みのノルムは本当に捨ててよいのか?
    ◯佐藤 祥太 (一橋), 木山 朔 (一橋), 平澤 寅庄 (一橋), 小町 守 (一橋)
    【受賞理由】本研究は、CLIPにおいて一般に正規化によって捨てられている埋め込みのノルムに着目し、その性質や有用性について丁寧な分析を行っています。着眼点の面白さに加え、分析結果を踏まえた提案手法によって実際に性能改善を示している点を高く評価しました。また、ポスターや発表も分かりやすく整理されており、補足資料も含めて研究内容を丁寧に伝える工夫がなされていた点も印象的でした。

エムスリー株式会社賞

  • タスクベクトルは説明可能かつ制御可能な成分に線型分解できる
    ◯堀場 幸也 (慶大), 趙 羽風 (理研/東北大), 矢向 高弘 (慶大)
    【受賞理由】LLMにタスク指示を与えるタスクベクトルについて、「何をするか(TR)」と「どう解くか(TL)」に分解したうえで、どのように合成すると最適か、分解したベクトルの妥当性はどうかという検証を行った研究です。ランダム分解でも良い解は得られる場合があるが、TRとTLに分解すると少ない探索で精度改善することを妥当として論じているのがわかりやすく、着想と検証の有効性を加味して選定させていただきました。

株式会社IVRy賞

  • 待つか、聞き返すか:日本語日常会話における修復開始タイミングのモデル化
    ◯行旨 王我 (京都工繊大), 延原 章平 (京都工繊大), 河野 誠也 (京都工繊大)
    【受賞理由】本研究では、対話において修復(聞き返し)が「いつ起こり」「何を対象に」「どのように開始されるか」の3点の分析を行っています。 聞き返しは対話を破綻させずに継続するために必要であるものの、「潜在的な対話の失敗要因であること」や「対話ターン数を増やしてしまう」など対話体験向上のためには発生しない対話設計が重要になります。 弊社でも対話システムの対話体験向上のために、実環境での対話データの分析を行なっており、今回の知見が失敗要因の分析に流用が期待できることからスポンサー賞に選定させていただきました。

株式会社マネーフォワード賞

  • 医療事故報告書の事故事象・背景要因・改善策と抽象化項目を結び付けたデータセットの構築
    ◯長谷山 優菜 (北大), 伊藤 友貴 (NICT), 坂地 泰紀 (北大), 野田 五十樹 (北大)
    【受賞理由】本研究は、医療事故報告書を医療分野の類似性ではなく背景や改善策などの類似性で検索できるようにするため、背景や改善策をより抽象的な項目と紐づけたデータセットを構築しています。 分野を跨いだ抽象概念で検索したい場面は、医療事故の領域だけでなく当社が扱う会計情報や、その他多くの領域で存在すると考えます。そうした将来的な実用性を評価し、スポンサー賞に選定しました。今後の発展に期待しております。

NTT株式会社賞

  • サプライザルは表記選好と逆相関する
    ◯山口 美咲 (東大), 三田 雅人 (東大), 磯野 真之介 (国語研), 大関 洋平 (東大/NII)
    【受賞理由】本研究はキャッチコピーを題材に「人間はどのような表記を好むのか?」を検証したものです。人間は処理しやすい・しづらい表現を好むとする流暢性仮説・非流暢性仮説の対立する理論に対して、大規模言語モデルのサプライザルを用いた検証を行い、流暢性仮説が支持されることを示しました。大規模言語モデルを介して人間の価値観を理解する新たなアプローチとしての面白さ・大規模言語モデルの研究開発において重要なアラインメントに新たな視点を提供する将来性の2点から、本研究をスポンサー賞に選定致しました。今後の更なる発展を期待しています。

朝日新聞社(メディア研究開発センター)賞

  • 選挙情報空間におけるクリックベイト的表現の効果:2025年参院選YouTube動画の傾向スコアマッチング分析
    ◯中村 響 (東大), 伊藤 和浩 (東大), 太田 光紀 (東大), 鳥海 不二夫 (東大)
    【受賞理由】当社では計算社会科学の中でも、特にインターネット上の言論空間に関する研究を推進しています。本研究は、報道現場でも関心の高いテーマに対し、傾向スコアマッチングによる因果推論を取り入れ、定量的な効果検証の枠組みを示した点を高く評価しました。計算社会科学の幅広い領域への発展・応用も期待し、選定しました。

株式会社松尾研究所賞

  • 対数尤度で捉えるLLMの流行シグナル
    ◯長井 夢歩 (日本女子大), 山下 果凛 (日本女子大), 長谷川 愛珠 (日本女子大), 西潟 優羽 (日本女子大), 倉光 君郎 (日本女子大)
    【受賞理由】PPLという基本指標から「語の浸透時期」という時間信号を読み出す着想がシンプルで直感的でした。それでいて複数年代・複数モデル・コントロール語正規化と体系的に検証されており、背景→着想→手法→実験→結果が一目で追える非常に綺麗なポスターだった点も含めて、スポンサー賞に選定させていただきました。

ストックマーク株式会社賞

  • VisEditBench: 視覚的指示を用いたダイアグラム編集ベンチマーク
    ◯種口 暁人 (東北大), 斉藤 いつみ (東北大/科学大/理研), 吉田 遥音 (東北大), 鈴木 潤 (東北大/理研/NII LLMC)
    【受賞理由】本研究では視覚的な指示によるMLLMのダイアグラム編集能力を評価するベンチマークを構築し, MLLMの視覚的指示遂行における弱点や難しさを提示しています. コード生成だけでなく画像編集モデルも含めて分析しており, 入出力ともに多様なモダリティを前提としたタスク設計は今後のMLLM研究の発展に寄与するものと考え, スポンサー賞に選定させていただきました.

株式会社日立製作所賞

  • 法律相談テキストデータセットにおける判例エンティティリンキング
    ◯南 理久 (豊橋技科大), 土屋 雅稔 (豊橋技科大)
    【受賞理由】法律などの専門知識を要する領域では,ユーザー視点の日常言語から専門的な情報をいかに正しく導くかが重要となります.本研究では,法律相談データと判例データベースを組み合わせ,回答文1,234件,参照判例1,402件からなる評価用データセットを構築されています.丁寧な目視確認や適切な負例設計など,実世界の課題に真摯に向き合った質の高い取り組みを評価し,日立製作所賞に選定いたしました.

弥生株式会社賞

  • 大規模言語モデルを用いた相談型掲示板の回答意図推定
    ◯羽鳥 なの香 (青学), 横山 暁 (青学)
    【受賞理由】本論文は,相談型掲示板における回答意図を分析し,共感的な支援だけでなく,意見表明や助言,ときには質問者への批判・修正といった働きかけも相応の比重を占めることを示しています.情緒的な寄り添いだけがコミュニケーションの中心ではないというこの観察は,質問意図と回答を的確に判断していくナレッジが求められる弊社のコールセンター業務にも通じるものです.回答意図という定量化の難しい対象に対して,まず語彙的な特徴を丁寧に洗い出し,その構造を理解しようとする分析的な姿勢も印象的です.経営学という異分野から,言語処理という手法で社会課題に挑むチャレンジングな研究であり,現場の課題を起点に技術を探索し,解決へとつなげていくアプローチは,弊社のスタンスとも重なるものです.今後のご活躍を大いに期待しています.

ハッカソン賞

独自モデル部門(OMD) 優秀賞

  • チーム1 - 国際センタに牛タンを
    伊藤大陽(一橋大), 戸田裕子(愛媛大), 壁谷宗汰(愛工大), 舘健太朗(愛県大), 行旨王我(京都工繊大), 阿部雄斗(早大)

事例設計部門(ICL) 優秀賞

  • チームc - 牛タン正直ナメてた
    宮田莉奈(愛媛大), 小林稜馬(北大), 森田知颯(東大), 白田連大(京都工繊大), 須貝優太(横国大), 長谷川永将(一橋大)

独自モデル部門(OMD) 審査員特別賞

  • チーム4 - まごたち
    松野智紀(SB Intuitions), 花房健太郎(愛媛大), 目時大暉(横浜市大/NII LLMC), 上野和樹(甲南大), 北村有彩(一橋大), 佐藤滉太(NAIST)

事例設計部門(ICL) 審査員特別賞

  • チームe - Eagles
    高山隼矢(SB Intuitions), 政野美和(一橋大/NII LLMC), 野村瑛吉(横国大), 須田愛未(東北大), 新垣嘉成太(愛工大), 田中優太朗(法政大)

独自モデル部門(OMD) YANS委員特別賞

  • チーム2 - 牛タンと、コーヒー。
    前川知歩(一橋大), 遠藤純音(NAIST), 高田尚輝(横国大), 湯澤広翔(東京電機大), 森貞堅湧(新居浜高専), 林美聡(法政大), 清水信希(愛媛大)
  • チーム5 - ほうじ茶
    倉本真菜(NAIST), 山下伊織(一橋大), 川田拓朗(法政大/ZOZO研究所), 大田眞滉(愛工大), 大塚雄貴(科学大), 田窪真大(愛媛大)

事例設計部門(ICL) YANS委員特別賞

  • チームf - 健康第一
    矢野千紘(SB Intuitions/名大), 前川大輔(愛媛大), 阿部貴駿(北大), 加藤郁花(横国大), 清水綾太(愛工大/NII LLMC), 細川喬介(一橋大)
  • チームg - 牛タン難民
    田代勇希(NAIST), 吉田希世(東北大), 山田美優(科学大), Lee JungHoon(東京電機大), 蛇谷祐人(小樽商科大), 山口哲平(愛媛大)

第21回言語処理若手シンポジウム(YANS2026) ポスターセッション トピック別索引

(A1) 語彙資源・辞書 Lexical Resources and Dictionaries / 2件

8/17 (月): シンポジウム2日目

[17:05-18:05] ポスターセッション (3)

  • [S3-P01] Constructing a Multilingual Parallel Corpus from Fandom Wikis: A Pokemon Case Study
    宋 玄遇 (NAIST), 尾崎 慎太郎 (NAIST), 林 和樹 (NAIST), 上垣外 英剛 (NAIST), 林 克彦 (東大), 渡辺 太郎 (NAIST)

8/18 (火): シンポジウム3日目

[13:20-14:20] ポスターセッション (5)

  • [S5-P39] 機械翻訳タスクにおける日本語文書単位容認性判断データセット構築と途中補完モデル
    松田 陵佑 (東北大), 工藤 慧音 (東北大/理研), 藤井 諒 (東北大/フューチャー), 伊藤 拓海 (東北大/MLS Inc.), 森下 睦 (東北大/フューチャー), 鈴木 潤 (東北大/理研)

(A2) 言語資源・アノテーションと評価 Language Resources, Annotation, and Evaluation / 51件

8/17 (月): シンポジウム2日目

[11:45-12:45] ポスターセッション (1)

  • [S1-P01] AIエージェントのためのツール呼び出し評価データJMultiWOZ-TCの構築
    清水 綾太 (愛工大/NII LLMC), 中山 功太 (NII LLMC), 守山 慧 (東大/NII LLMC), 徳久 良子 (愛工大/理研), 宮尾 雄介 (東大/NII LLMC)

  • [S1-P02] マルチホップ推論の内容と遷移に基づくグラフ構造を用いた自動分析
    大崎 稜司 (豊田工大), 三輪 誠 (豊田工大)

  • [S1-P03] 典拠に基づいた事実性判定テストセットの構築
    田口 凜采 (豊橋技科大), 土屋 雅稔 (豊橋技科大/NICT)

  • [S1-P04] 大規模NERデータセット構築に向けた単語置換によるデータ拡張
    前川 大輔 (愛媛大), 藤井 諒 (フューチャー), 森下 睦 (フューチャー), 梶原 智之 (愛媛大/阪大)

  • [S1-P05] オンライン記事の引用に伴う解釈変化を捉えるデータセット構築
    後藤 隆希 (横浜国大), 吉田 光男 (筑波大), 村山 太一 (横浜国大)

  • [S1-P11] 認知症カフェの対話音声を用いた音声感情認識に向けたデータ構築と分析
    山川 祥 (武蔵野大工), 佐々木 多希子 (武蔵野大工)

  • [S1-P15] VLMは複雑な表画像をどこまで読めるか? ― 行数・列数・セル結合を制御した表構造認識の性能分析 ―
    會田 勇斗 (ストックマーク), 陳 実 (ストックマーク), 森長 誠 (ストックマーク), 田中 翔平 (ストックマーク), 有馬 幸介 (ストックマーク)

  • [S1-P21] 実テキストを参照した多様なLLMデータ拡張
    平松 優弥 (豊田工大), 井田 龍希 (豊田工大), 三輪 誠 (豊田工大)

  • [S1-P25] 汎用テキスト評価モデル構築に向けた評価観点の自律的選択能力の検証
    田中 杏 (お茶大), 小林 一郎 (お茶大)

  • [S1-P27] 日本語文章の道徳的判断における人間とLLMの情報要求量の差異分析
    伊藤 達也 (法政), 大橋 巧 (法政), 彌冨 仁 (法政)

  • [S1-P29] 子どもにとって安全なLLMとは?〜想定応答に対する人手評価とLLM-as-a-judgeの比較分析〜
    野村 瑛吉 (横国大), 杉山 弘晃 (AISI), 黒田 麻衣子 (山陽学園大), 清水 良太郎 (早大), 高橋 史 (信州大), 高見 享佑 (大教大), 安藤 祐介 (みんなのコード), 中山 功太 (NII LLMC), 森 辰則 (横国大)

  • [S1-P44] 小学校漢字学習におけるLLM生成物語の「違和感」の類型化とLLM間の比較
    吉村 賢人 (大教大), 高見 享佑 (大教大), 古橋 萌々香 (東北大/NII LLMC), 中山 功太 (NII LLMC), 児玉 貴志 (NII LLMC)

  • [S1-P48] 形態素トークナイザーの効果検証に向けた日本語エンティティ追跡ベンチマークの構築 【デモあり】
    舘 健太朗 (愛県大), 坪倉 和哉 (愛県大), 入部 百合絵 (愛県大)

  • [S1-P49] 特許請求項翻訳評価のためのルーブリックに基づくLLM-as-a-Judgeの提案 【デモあり】
    FU YINGYI (筑波大), 宇津呂 武仁 (筑波大), 永田 昌明 (CS研)

[14:25-15:25] ポスターセッション (2)

  • [S2-P01] 日本語エージェントベンチマーク「J-tau」の構築
    矢野 千紘 (SB Intuitions/名大), 平子 潤 (SB Intuitions), 廣淵 亮太 (SB Intuitions)

  • [S2-P02] 「待つ」は一瞬か数時間か:LLMによるイベント持続時間の評価
    松﨑 孝介 (東北大), 谷口 雅弥 (理研)

  • [S2-P03] 日本語マルチモーダル埋め込みベンチマーク構築の検討
    李 聖哲 (SB Intuitions), 小川 隼斗 (SB Intuitions)

  • [S2-P04] 校正・校閲データセット構築に向けた記事編集者の指摘情報に対する誤り分類
    岩本 和真 (日経), 白井 穂乃 (日経)

  • [S2-P05] 言葉を介した観測と物理モデルを統合した人流推定
    佐久間 大地 (慶應), 井上 正樹 (慶應)

  • [S2-P06] 法律相談テキストデータセットにおける判例エンティティリンキング
    南 理久 (豊橋技科大), 土屋 雅稔 (豊橋技科大)

  • [S2-P32] VisEditBench: 視覚的指示を用いたダイアグラム編集ベンチマーク
    種口 暁人 (東北大), 斉藤 いつみ (東北大/科学大/理研), 吉田 遥音 (東北大), 鈴木 潤 (東北大/理研/NII LLMC)

[17:05-18:05] ポスターセッション (3)

  • [S3-P02] 医療事故報告書の事故事象・背景要因・改善策と抽象化項目を結び付けたデータセットの構築
    長谷山 優菜 (北大), 伊藤 友貴 (NICT), 坂地 泰紀 (北大), 野田 五十樹 (北大)

  • [S3-P03] 進歩性判定のための主引用・副引用構造を反映した特許拒絶理由データセットの構築
    白鳥 華枝 (一橋大), 山本 直生 (一橋大), 山田 寛章 (都立大), 河野 誠也 (京都工芸繊維大), 相澤 彰子 (NII), 欅 惇志 (一橋大)

  • [S3-P04] 日本語MWE用法判断におけるアノテータ型LLMエージェントの比較分析
    大橋 美緒 (一橋), 小町 守 (一橋)

  • [S3-P05] 教育AIエージェントのための授業指導案データセット構築に向けて
    間瀬 なる美 (大教大)

  • [S3-P06] クロスモーダル意匠理解に向けた日本語意匠公報データセット構築とベンチマーク設計
    白田 連大 (京都工繊大), 野中 尋史 (愛工大), 延原 章平 (京都工繊大), 河野 誠也 (京都工繊大)

  • [S3-P14] 文字と質問の対応関係を保証した日本語シーンテキストVQAデータの合成と学習に向けて
    前田 航希 (科学大/NII LLMC), 岡崎 直観 (科学大/NII LLMC)

  • [S3-P16] MECHA-ja を用いた人間とVLMの常識理解の差の分析に向けて
    濱本 惇之介 (愛媛大/NII LLMC), 中山 功太 (NII LLMC), 徳久 良子 (愛工大/理研), 二宮 崇 (愛媛大), 岡崎 直観 (NII LLMC/科学大/産総研)

  • [S3-P21] 法規・規格文書の参照構造を考慮した知識グラフデータセットと構築基準の検討
    阿部 貴駿 (北大), 松藤 彰宏 (パナソニックエレクトリックワークス), 廣瀬 良文 (パナソニックエレクトリックワークス), 平山 大世 (北大), 坂地 泰紀 (北大), 野田 五十樹 (北大)

  • [S3-P29] マルチターン対話の安全性は言語と文化のどちらに依存するのか?日本語と英語の比較研究
    五十里 渚 (早大), 福田 創 (早大), 高山 隼矢 (SB Intuitions), 綿岡 晃輝 (SB Intuitions), 河原 大輔 (早大)

  • [S3-P30] 有害カテゴリのマルチラベルデータセットの構築とカテゴリ間相互作用の分析
    北村 有彩 (一橋大), 佐藤 祥太 (一橋大), 小町 守 (一橋大), 鈴木 久美 (NII LLMC), 欅 惇志 (一橋大)

  • [S3-P37] Benchmark Construction Pathways as Measurement Variables: A Controlled Khmer Case Study
    LOEM Mengsay (PFN), LAY Kimseng (東北大)

  • [S3-P44] DuplexChat:音声対話言語モデルのための大規模全二重音声対話コーパス
    中田 亘 (東大/産総研), 齋藤 佑樹 (東大/産総研), 猿渡 洋 (東大)

8/18 (火): シンポジウム3日目

[10:40-11:40] ポスターセッション (4)

  • [S4-P01] 事実検証ベンチマーク構築に向けた新聞訂正記事10年分の誤り分析
    山内 洋輝 (朝日新聞社), 田森 秀明 (朝日新聞社)

  • [S4-P02] 一般家庭における調理動画の安定収集を目的としたWebシステムの提案
    壁谷 宗汰 (愛工大), 徳久 良子 (愛工大/理研)

  • [S4-P03] インターネットラジオを用いた日本語諸方言音声コーパスの半自動構築
    中島 未唯 (慶大), 佐藤 なな子 (慶大), 高道 慎之介 (慶大/東大)

  • [S4-P04] 大規模言語モデルによる数学解説生成のための学習データセットの構築
    高須 弘政 (愛工大), 鳥巣 裕斗 (愛工大/NII LLMC), 徳久 良子 (愛工大/理研)

  • [S4-P15] Where Do Vision-Language Models Preserve and Use Depth Information?
    陳 冠帆 (法政大), 川田 拓朗 (法政大), 守田 竜梧 (RPTU & DFKI), 北田 俊輔 (法政大), 彌冨 仁 (法政大/法政大)

  • [S4-P17] Grounding Word Senses in Vision: Multimodal Word Sense Induction
    金 熙洙 (一橋), 凌 志棟 (一橋), 木山 朔 (一橋), 小町 守 (一橋)

  • [S4-P27] LLMの日本語音象徴理解を測るベンチマーク構築にむけた検討
    三浦 秀隆 (慶大), 深尾 貫太 (慶大), 清水 周一郎 (慶大), 高道 慎之介 (慶大/東大)

  • [S4-P39] ニュース記事に対する読者感情分布の推定に向けて
    山口 哲平 (愛媛大), 花房 健太郎 (愛媛大), 近藤 里咲 (愛媛大), 梶原 智之 (愛媛大/阪大), 早志 英朗 (阪大), 中島 悠太 (阪大), 長原 一 (阪大)

  • [S4-P47] 事前学習コーパスの栄養成分表示 【デモあり】
    源 怜維 (早大/LLMC), 藤田 一颯 (早大/LLMC), 清丸 寛一 (LLMC), 小田 悠介 (LLMC), 児玉 貴志 (LLMC), 河原 大輔 (早大/LLMC)

  • [S4-P49] LLM-as-a-Judgeを用いた金融ニュース因果関係説明生成の評価 【デモあり】
    謝 宇程 (筑波大), 小齋 友里菜 (筑波大), 土田 陸斗 (筑波大), 宇津呂 武仁 (筑波大)

[13:20-14:20] ポスターセッション (5)

  • [S5-P01] 対話(たいわ)におけるLLMの漢字(かんじ)読(よ)み能⼒(のうりょく)の評価(ひょうか)
    青野 広太郎 (SB Int), 髙山 隼矢 (SB Int)

  • [S5-P02] 元データの評価観点を保持した制御可能なQAデータ拡張
    小島 亮 (豊田工大), 三輪 誠 (豊田工大)

  • [S5-P03] 多角的なアノテーター間依存を考慮した観点別ラベル推定の効率化
    小林 稜馬 (北大), 李 吉屹 (北大)

  • [S5-P04] 機密情報検知を目的とした日本語NERスキーマの提案とデータセットの構築
    髙橋 遼 (Acompany), 小林 滉河 (Acompany), 平岡 拓海 (Acompany)

  • [S5-P26] 文化的に潜在化したメンタルヘルスリスクに対するLLM応答の安全性評価ベンチマークの構築
    嵐 大樹 (奈良医大), 久田 祥平 (NAIST), 折茂 圭介 (Ubie), 太田 満久 (Ubie), 風間 正弘 (Ubie), 五十嵐 健史 (Ubie), 荒牧 英治 (NAIST)

  • [S5-P31] LLM-as-a-Judgeにおける絶対評価と相対評価の整合性はスコア帯でどのように変わるか?
    山下 伊織 (一橋大), 木山 朔 (一橋大), 伊藤 大陽 (一橋大), 小町 守 (一橋大)

  • [S5-P45] 誤情報拡散防止のためのコミュニティノート収集およびデータセット作成 【デモあり】
    山本 勇太 (筑波大), 田口 雄大 (筑波大), 嶋津 瑛 (筑波大), 王 婧薇 (筑波大), 宇津呂 武仁 (筑波大)

  • [S5-P47] 待つか、聞き返すか:日本語日常会話における修復開始タイミングのモデル化
    行旨 王我 (京都工繊大), 延原 章平 (京都工繊大), 河野 誠也 (京都工繊大)

(A3) 計算・形式言語学 Computational and Formal Linguistics / 6件

8/17 (月): シンポジウム2日目

[14:25-15:25] ポスターセッション (2)

  • [S2-P07] 口語オランダ語・フラマン語において動詞クラスター内語順を決定する要因の最大エントロピーモデルでの分析
    田中 醇之介 (東大), 林 克彦 (東大)

[17:05-18:05] ポスターセッション (3)

  • [S3-P07] Zipf則の頑健性――『残像に口紅を』を題材に
    中石 海 (理研/国語研)

8/18 (火): シンポジウム3日目

[10:40-11:40] ポスターセッション (4)

  • [S4-P05] 実コーパスと合成コーパスを用いたレジスタ別比喩出現率の検証
    上野 和樹 (甲南大), 永田 亮 (甲南大), 川崎 義史 (東大), 長谷部 陽一郎 (同志社大), 大谷 直輝 (東京外大), 高村 大也 (産総研)

  • [S4-P22] 自然言語タスク指示に基づく信号時相論理仕様を用いた自律移動ロボットの制御
    芹澤 和伸 (阪大), 橋本 和宗 (阪大)

[13:20-14:20] ポスターセッション (5)

  • [S5-P05] 単語の共起行列の非負値因子行列分解による意味変化の分析
    木山 朔 (一橋大), 相田 太一 (一橋大), 小町 守 (一橋大), 小木曽 智信 (国語研), 高村 大也 (産総研), 持橋 大地 (国語研/統数研)

  • [S5-P33] 構文文法に基づく言語モデルの構文獲得メカニズムの分析
    九門 涼真 (東大/理研), 谷中 瞳 (東大/理研/東北大)

(A4) 心理言語学・認知モデリング Psycholinguistics and Cognitive Modeling / 8件

8/17 (月): シンポジウム2日目

[11:45-12:45] ポスターセッション (1)

  • [S1-P06] 生活者解釈と実務的規範解釈を中間表現とする広告法務審査の潜在変数モデル化に向けた検討
    石垣 龍馬 (HT), 森川 祐介 (HT)

  • [S1-P40] 笑い声先読みに基づくプロアクティブ対話システム
    内山 大希 (科学大)

[14:25-15:25] ポスターセッション (2)

  • [S2-P07] 口語オランダ語・フラマン語において動詞クラスター内語順を決定する要因の最大エントロピーモデルでの分析
    田中 醇之介 (東大), 林 克彦 (東大)

  • [S2-P08] 現代日本語短歌における脳内感情処理機構の解明へ向けて
    黒川 真琳 (お茶大), 持橋 大地 (統数研/国語研), 小林 一郎 (お茶大)

  • [S2-P46] 抽象的な言葉からのWebサイトのデザイン自動生成 【デモあり】
    山本 葵 (愛工大), 徳久 良子 (愛工大/理研)

[17:05-18:05] ポスターセッション (3)

  • [S3-P07] Zipf則の頑健性――『残像に口紅を』を題材に
    中石 海 (理研/国語研)

8/18 (火): シンポジウム3日目

[10:40-11:40] ポスターセッション (4)

  • [S4-P06] AnaToMを用いた大規模言語モデルの心の理論に関する詳細分析
    Lee JungHoon (電大), 前田 英作 (電大)

[13:20-14:20] ポスターセッション (5)

  • [S5-P06] サプライザルは表記選好と逆相関する
    山口 美咲 (東大), 三田 雅人 (東大), 磯野 真之介 (国語研), 大関 洋平 (東大/NII)

(A7) その他の言語学 Other Areas of Linguistics / 3件

8/17 (月): シンポジウム2日目

[14:25-15:25] ポスターセッション (2)

  • [S2-P02] 「待つ」は一瞬か数時間か:LLMによるイベント持続時間の評価
    松﨑 孝介 (東北大), 谷口 雅弥 (理研)

8/18 (火): シンポジウム3日目

[10:40-11:40] ポスターセッション (4)

  • [S4-P05] 実コーパスと合成コーパスを用いたレジスタ別比喩出現率の検証
    上野 和樹 (甲南大), 永田 亮 (甲南大), 川崎 義史 (東大), 長谷部 陽一郎 (同志社大), 大谷 直輝 (東京外大), 高村 大也 (産総研)

  • [S4-P29] LLMは「日本語のゆれ」に対する日本語話者の容認度を再現するか
    高山 隼矢 (SB Intuitions)

(B1) 形態素・構文解析 Morphological and Syntactic Analysis / 5件

8/17 (月): シンポジウム2日目

[11:45-12:45] ポスターセッション (1)

  • [S1-P09] End-to-Endモデルに基づく係り受け解析と語順整序の同時実行
    箭内 太郎 (東京電機大), 大野 誠寛 (東京電機大)

[14:25-15:25] ポスターセッション (2)

  • [S2-P09] 語彙制約を用いた生成モデルによる仮名漢字変換
    土手 陸渡 (東京電機大), 大野 誠寛 (東京電機大)

  • [S2-P42] 多人数対話の談話構造解析:LLM を用いた依存構造・対話行為の判定
    高田 尚輝 (横国大), 大勝 友洋 (横国大), 森 辰則 (横国大)

[17:05-18:05] ポスターセッション (3)

  • [S3-P08] 複統合的言語 アイヌ語のサブワード分割 〜機械翻訳モデルに最適なトークナイザーとは〜
    中田 琉稀 (東大後期教養), 花田 佳文 (東大言語情報), 林 克彦 (東大言語情報)

8/18 (火): シンポジウム3日目

[10:40-11:40] ポスターセッション (4)

  • [S4-P24] Leveraging the multi-script Japanese writing system to apply the SpaceByte architecture
    波山 慎子 (奈女大), 須藤 克仁 (奈女大)

(B2) 意味論・意味解析 Semantics and Semantic Analysis / 8件

8/17 (月): シンポジウム2日目

[11:45-12:45] ポスターセッション (1)

  • [S1-P07] 生成AIはプランニングできるのか? ― 暗黙知を含む料理タスクのシングル/マルチタスク生成 ―
    十津 梨治句 (愛工大), 徳久 良子 (愛工大/理研)

  • [S1-P26] オチ(punchline)あるいはtwist ending型物語を対象としたLLMによる結末理解の説明タスク
    程 嘉実 (筑波大), 宇津呂 武仁 (筑波大)

  • [S1-P46] テキストの意味的ソート・順序制約付き意味的ソート 【デモあり】
    福地 成彦 (SB Intuitions)

[14:25-15:25] ポスターセッション (2)

  • [S2-P46] 抽象的な言葉からのWebサイトのデザイン自動生成 【デモあり】
    山本 葵 (愛工大), 徳久 良子 (愛工大/理研)

[17:05-18:05] ポスターセッション (3)

  • [S3-P09] 階層的な質問による解釈可能なテキスト埋め込み
    小田 康平 (JAIST), 荘 博閔 (東芝)

8/18 (火): シンポジウム3日目

[10:40-11:40] ポスターセッション (4)

  • [S4-P07] Neural KWIC:KWIC 形式用例からの動的単語埋め込みの獲得と可視化
    島田 真緒 (一橋大), 木山 朔 (一橋大), 凌 志棟 (一橋大), 小町 守 (一橋大), 小木曽 智信 (国語研), 高村 大也 (産総研), 持橋 大地 (国語研/統数研)

[13:20-14:20] ポスターセッション (5)

  • [S5-P05] 単語の共起行列の非負値因子行列分解による意味変化の分析
    木山 朔 (一橋大), 相田 太一 (一橋大), 小町 守 (一橋大), 小木曽 智信 (国語研), 高村 大也 (産総研), 持橋 大地 (国語研/統数研)

  • [S5-P07] 「掻痒」は「そう痒」より伝わるのか? ―医療用語における漢字表記の理解可能性の検討―
    倉本 真菜 (奈良先端大), 永井 宥之 (奈良先端大), 西山 智弘 (奈良先端大), 若宮 翔子 (奈良先端大), 荒牧 英治 (奈良先端大)

(B3) 文脈解析 Contextual Analysis / 6件

8/17 (月): シンポジウム2日目

[14:25-15:25] ポスターセッション (2)

  • [S2-P27] 言語モデルは文脈に依存する個人情報を検知できるのか
    西潟 優羽 (日本女子大), 山下 果凜 (日本女子大), 倉光 君郎 (日本女子大)

  • [S2-P31] Beyond Recomputation: Direct Routing as a General Information-Reuse Strategy in LLMs
    李 睿 (JAIST), 趙 羽風 (理研/東北大), 井之上 直也 (JAIST/理研)

[17:05-18:05] ポスターセッション (3)

  • [S3-P04] 日本語MWE用法判断におけるアノテータ型LLMエージェントの比較分析
    大橋 美緒 (一橋), 小町 守 (一橋)

  • [S3-P13] 長尺音声のための談話グラフ誘導型同時音声翻訳
    矢野 祐貴 (SCSK), Qin Xiuyuan (SCSK), 小林 樹 (SCSK)

8/18 (火): シンポジウム3日目

[10:40-11:40] ポスターセッション (4)

  • [S4-P08] 大規模言語モデルを用いた相談型掲示板の回答意図推定
    羽鳥 なの香 (青学), 横山 暁 (青学)

  • [S4-P40] コモングラウンドを用いた対話的協働におけるすれ違いの可視化と修復
    嶌根 伸一 (科学大), 吉野 幸一郎 (科学大/阪大), 荒瀬 由紀 (科学大), 佐藤 拓真 (奈良先端大)

(B4) テキスト生成 Text Generation / 28件

8/17 (月): シンポジウム2日目

[11:45-12:45] ポスターセッション (1)

  • [S1-P08] 複数の文章を読んで文書集合全体を把握して初めて回答できるベンチマーク
    出合 優実 (NAIST), 氷見 和 (NAIST), 柴田 大作 (NEC), 辻川 剛範 (NEC), 清水 聖司 (NAIST), 西山 智弘 (NAIST), 若宮 翔子 (NAIST), 荒牧 英治 (NAIST)

  • [S1-P09] End-to-Endモデルに基づく係り受け解析と語順整序の同時実行
    箭内 太郎 (東京電機大), 大野 誠寛 (東京電機大)

  • [S1-P17] 観光キャッチコピー自動生成に向けた学習用データセットの構築
    鳥巣 裕斗 (愛工大/NII LLMC), 徳久 良子 (愛工大/理研)

  • [S1-P24] 異なる語彙を持つ LLM 間のオンポリシ蒸留
    木村 優介 (JST/名大/同大), 駒水 孝裕 (名大), 波多野 賢治 (同大), 石川 佳治 (名大)

  • [S1-P45] 意外性と実現可能性を両立する異分野転用アイデア創出のための自律的探索エージェント
    進藤 尚希 (ストックマーク/電通大), 広田 航 (ストックマーク), 高橋 洸丞 (ストックマーク), 有馬 幸介 (ストックマーク)

  • [S1-P47] 誤情報拡散防止を目的としたXポストへのコミュニティノート付与手法の提案 【デモあり】
    嶋津 瑛 (筑波大), 田口 雄大 (筑波大), 山本 勇太 (筑波大), 王 婧薇 (筑波大), 宇津呂 武仁 (筑波大)

[14:25-15:25] ポスターセッション (2)

  • [S2-P09] 語彙制約を用いた生成モデルによる仮名漢字変換
    土手 陸渡 (東京電機大), 大野 誠寛 (東京電機大)

  • [S2-P10] 難易度制御のための適応的事例選択に基づく検索拡張生成
    宮田 莉奈 (愛媛大), 梶原 智之 (愛媛大/阪大)

  • [S2-P11] 生成過程の段階的分解によるフロー言語モデルの品質改善
    大塚 雄貴 (科学大), 大葉 大輔 (科学大), 岡崎 直観 (科学大/産総研/NII LLMC)

  • [S2-P12] 質問駆動型の情報抽出による将棋AI指し手の対話的解説生成
    大原 蒼生 (理科大)

  • [S2-P26] 検証拡張生成: LLM 応答の真偽検証結果に基づく再生成
    政野 美和 (一橋大/NII LLMC), 欅 惇志 (一橋大), 欅 リベカ (東京工科大), 市岡 奨平 (一橋大/NII LLMC), 河原 大輔 (NII LLMC/早大)

  • [S2-P30] Activation Steeringにおける文章崩壊の抑制に向けた初期検討
    西山 天 (法政大), 川田 拓朗 (法政大), 北田 俊輔 (法政大), 永井 大地 (法政大), 彌冨 仁 (法政大)

  • [S2-P50] ギャルは口調だけで成らず:当事者インタビューに基づく対話AIペルソナの設計と実装 【デモあり】
    池上 桃花 (駒大/産総研), 栗林 雅希 (早大), 加藤 卓哉 (駒大), 大西 正輝 (産総研), 平井 辰典 (駒大)

[17:05-18:05] ポスターセッション (3)

  • [S3-P10] LLM-as-a-Judgeのフィードバックを用いた株価変動理由記事の繰り返し生成
    小齋 友里菜 (筑波大学), 土田 陸斗 (筑波大学), 謝 宇程 (筑波大学)

  • [S3-P11] 句を考慮したマスク拡散言語モデル
    山内 大暉 (豊田工大), 三輪 誠 (豊田工大)

  • [S3-P18] 動画生成モデルにおける直喩理解と喩体の生成挙動
    王 略丞 (東大), 尾崎 慎太郎 (NAIST), 上垣外 英剛 (NAIST), 林 克彦 (東大), Kwon Jingun (CNU), 奥村 学 (科学大), 渡辺 太郎 (NAIST)

  • [S3-P23] トークン単位のメモリを備えた離散拡散言語モデル
    樫森 信平 (豊田工大), 三輪 誠 (豊田工大)

  • [S3-P25] 誹謗中傷文出力に対するJailbreakリスクに論理式プロンプトが与える影響の分析
    加藤 郁花 (横浜国大), 佐藤 心 (横浜国大), 石川 凌 (横浜国大), 野澤 遼太郎 (横浜国大), 高田 尚輝 (横浜国大), 森 辰則 (横浜国大)

  • [S3-P31] LLMは邪馬台国論争の論文をどう評価するのか?
    前原 茜 (日本女子大), 森部 七海 (日本女子大), 西潟 優羽 (日本女子大), 倉光 君郎 (日本女子大)

  • [S3-P43] LLMによるインタビューにおける深堀り質問展開戦略の比較・評価
    土田 陸斗 (筑波大学), 園田 哲也 (筑波大学), 宇津呂 武仁 (筑波大学)

8/18 (火): シンポジウム3日目

[10:40-11:40] ポスターセッション (4)

  • [S4-P09] 依存構造木に基づく拡散言語モデルのマスク過程制御
    大畑 綾音 (豊田工大), 三輪 誠 (豊田工大)

  • [S4-P10] Tanka Diffusion ―拡散モデルによる短歌の自動生成―
    羽根田 賢和 (東北大), 坂口 慶祐 (東北大/理研)

  • [S4-P26] 多言語LLMの政治的回答分布は国別意見分布と一致するかーCSESを用いた比較分析ー
    植田 雄士 (奈良先端大), 上田 健太郎 (奈良先端大), 鳥海 不二夫 (東大), 荒川 豊 (九大), 安本 慶一 (奈良先端大), 諏訪 博彦 (奈良先端大)

  • [S4-P42] 発話と応答の感情を独立に考慮した共感自由対話システムの構築
    山本 聖留 (JAIST), 白井 清昭 (JAIST)

  • [S4-P46] LLMによるペルソナ駆動型移動シミュレーション:多様な身体・心理的制約下での意思決定のための満足度評価
    遠藤 純音 (奈良先端大), 久田 祥平 (奈良先端大), 荒牧 英治 (奈良先端大), 若宮 翔子 (奈良先端大)

[13:20-14:20] ポスターセッション (5)

  • [S5-P08] 大規模言語モデルの埋め込みノルムに基づく連続的な文難易度制御に向けて
    野々村 奏 (愛媛大), 梶原 智之 (愛媛大/阪大), 荒瀬 由紀 (科学大)

  • [S5-P09] 拡散言語モデルの社会的バイアスに与えるサンプリング設定の影響
    齋藤 幸史郎 (科学大), 大葉 大輔 (科学大), Bollegala Danushka (UoL), 岡崎 直観 (科学大/産総研/NII LLMC)

  • [S5-P16] 画像サイズ変換を用いた視覚言語モデルに対する敵対的攻撃検出
    付 宇軒 (早大), 王 昊 (早大), 何 金松 (早大), 河原 大輔 (早大)

(B5) 音声言語処理 Speech and Language Processing / 22件

8/17 (月): シンポジウム2日目

[11:45-12:45] ポスターセッション (1)

  • [S1-P10] 「今一度」より「今井ちど」? 意図的な誤字プロンプトによるTTSの調整
    千頭和 翔悟 (IVRy/慶応大), 吉田 快 (IVRy), 町田 雄一郎 (IVRy)

  • [S1-P11] 認知症カフェの対話音声を用いた音声感情認識に向けたデータ構築と分析
    山川 祥 (武蔵野大工), 佐々木 多希子 (武蔵野大工)

  • [S1-P12] 自動音声認識器を用いたアクセント位置検出
    三上 万里菜 (東京理科大), 松崎 拓也 (東京理科大)

  • [S1-P39] J-RhymeDetector: 日本語ラップにおける押韻スパン検出モデルの構築
    小川 隼斗 (早大), 河原 大輔 (早大)

  • [S1-P50] 運転負荷に合わせた音声対話システム 【デモあり】
    新垣 嘉成太 (愛工大), 徳久 良子 (愛工大/理研)

[14:25-15:25] ポスターセッション (2)

  • [S2-P13] 音声対話システムにおける未知語獲得のための音節認識確信度を用いた不要な聞き返し抑制
    古田 拓己 (産研), 武田 龍 (産研), 駒谷 和範 (産研)

  • [S2-P40] 音声対話における発話タイミング予測
    大西 一誉 (奈良先端/理研/阪大), 大中 緋慧 (奈良先端/理研), 吉野 幸一郎 (奈良先端/理研/阪大/科学大)

  • [S2-P47] 漸進的音声合成におけるSpeechLMからのフィードバックを用いたチャンク境界の最適化 【デモあり】
    小林 樹 (SCSK), Qin Xiuyuan (SCSK), 矢野 祐貴 (SCSK)

  • [S2-P48] 北海道アイヌ語に対する音声合成モデルの学習と評価 【デモあり】
    花田 佳文 (東大), 中田 琉稀 (東大), 林 克彦 (東大)

[17:05-18:05] ポスターセッション (3)

  • [S3-P12] 前臨床期アルツハイマー病検出に向けた高齢者自由会話音声認識の検討
    種村 圭師 (愛県大), 坪倉 和哉 (愛県大), 入部 百合絵 (愛県大), 北岡 教英 (豊橋技科大)

  • [S3-P13] 長尺音声のための談話グラフ誘導型同時音声翻訳
    矢野 祐貴 (SCSK), Qin Xiuyuan (SCSK), 小林 樹 (SCSK)

  • [S3-P47] 音声合成モデルのパラメータ演算による任意話者の声質での方言合成 【デモあり】
    三森 俊祐 (SB Int/早大), 水本 智也 (SB Int), 藤田 雄介 (SB Int)

8/18 (火): シンポジウム3日目

[10:40-11:40] ポスターセッション (4)

  • [S4-P03] インターネットラジオを用いた日本語諸方言音声コーパスの半自動構築
    中島 未唯 (慶大), 佐藤 なな子 (慶大), 高道 慎之介 (慶大/東大)

  • [S4-P11] Low-Resource Burmese-to-Japanese Speech Translation with LLM-Generated Data and LLM-as-Judge
    KHINE ZAR THWE (奈良先端科学技術大学院大学(NAIST)), 大内 啓樹 (奈良先端科学技術大学院大学(NAIST)), Sakti Sakriani (奈良先端科学技術大学院大学(NAIST))

  • [S4-P12] 言語特異的ニューロンの抑制による学習フリーなクロスリンガル音声合成の品質改善
    増子 凱斗 (エクサウィザーズ), 和田 和浩 (エクサウィザーズ), 櫻井 大雅 (エクサウィザーズ)

  • [S4-P13] 4者の会話における会話特性の分析
    清水 周一郎 (慶應大), 高道 慎之介 (慶應大/東大)

[13:20-14:20] ポスターセッション (5)

  • [S5-P10] Diagnosing Dialect Bias in Whisper ASR across Korean and Mandarin
    LIM DONGHUI (科学大/Hanyang Univ.), 岡崎 直観 (科学大), 馬 尤咪 (科学大)

  • [S5-P11] Speech-Text-to-Text対話モデルにおける速度と精度のトレードオフ
    中畔 彪雅 (奈良先端大/理研/阪大), 吉野 幸一郎 (理研/阪大)

  • [S5-P12] Full-duplex音声対話システムの雑音頑健性評価
    中野 隼輔 (東大), 中田 亘 (東大), 齋藤 佑樹 (東大), 猿渡 洋 (東大)

  • [S5-P13] 発声に基づく動的な音響特徴量融合による音声感情認識
    清水 信希 (愛媛大), 濱本 惇之介 (愛媛大), 二宮 崇 (愛媛大), 後藤 功雄 (愛媛大)

  • [S5-P15] 「もったり」から「こんがり」まで、調理を感覚語で実況する
    小酒井 健真 (愛工大), 徳久 良子 (愛工大/理研)

  • [S5-P20] 連続プロンプトチューニングを活用したキャラクター模倣音声対話システムの構築
    金子 拓正 (電通大), 稲葉 通将 (電通大)

(B6) マルチモーダル Multimodal / 47件

8/17 (月): シンポジウム2日目

[11:45-12:45] ポスターセッション (1)

  • [S1-P12] 自動音声認識器を用いたアクセント位置検出
    三上 万里菜 (東京理科大), 松崎 拓也 (東京理科大)

  • [S1-P13] 言語想起時の言語中枢間の位相同期に着目した単語認識
    小島 咲良 (愛県大), 長瀬 南帆 (愛県大), 坪倉 和哉 (愛県大), 入部 百合絵 (愛県大)

  • [S1-P15] VLMは複雑な表画像をどこまで読めるか? ― 行数・列数・セル結合を制御した表構造認識の性能分析 ―
    會田 勇斗 (ストックマーク), 陳 実 (ストックマーク), 森長 誠 (ストックマーク), 田中 翔平 (ストックマーク), 有馬 幸介 (ストックマーク)

  • [S1-P16] CLIPにおける埋め込みのノルムは本当に捨ててよいのか?
    佐藤 祥太 (一橋), 木山 朔 (一橋), 平澤 寅庄 (一橋), 小町 守 (一橋)

  • [S1-P17] 観光キャッチコピー自動生成に向けた学習用データセットの構築
    鳥巣 裕斗 (愛工大/NII LLMC), 徳久 良子 (愛工大/理研)

  • [S1-P18] 図表解像度に着目したVLMのハルシネーション傾向の分析
    根本 さくら (日本女子大学), 土田 悠佳 (日本女子大学大学院), 宮田 侑佳 (日本女子大学大学院), 倉光 君郎 (日本女子大学)

  • [S1-P19] VLMで軽量なフィジカルAIを作れるか?
    小林 稜佳 (日本女子大学), 土田 悠佳 (日本女子大学), 根本 さくら (日本女子大学), 西潟 優羽 (日本女子大学), 倉光 君郎 (日本女子大学)

[14:25-15:25] ポスターセッション (2)

  • [S2-P03] 日本語マルチモーダル埋め込みベンチマーク構築の検討
    李 聖哲 (SB Intuitions), 小川 隼斗 (SB Intuitions)

  • [S2-P14] 複数のスポーツ競技映像と実況テキスト対が視覚言語モデルの性能に与える影響
    島野 雄貴 (NHK), 熊野 正 (NHK)

  • [S2-P15] 再帰的Transformerはデータ制約下で何に効いて何に効かないのか
    堀田 大智 (青学), 小橋 洋平 (東大), 小島 武 (東大), 岩澤 有祐 (東大), 松尾 豊 (東大)

  • [S2-P16] VLAを用いたUAVナビゲーションのための未来予測と過去検証に基づく推論時スケーリング
    大井 聖也 (Science Tokyo), 宮西 大樹 (東大), 岡崎 直観 (Science Tokyo/産総研/NII LLMC)

  • [S2-P17] 長尺動画生成タスクにおけるプロンプトと動画間のシーン対応を考慮した自動評価
    吉田 遥音 (東北大), 工藤 慧音 (東北大), 松田 陵佑 (東北大), 清水 伸幸 (LINEヤフー), 鈴木 潤 (東北大)

  • [S2-P18] フォントはVLMの日本語テキスト画像理解に影響するのか?
    戸田 裕子 (愛媛大), 米山 瑛人 (愛媛大), 梶原 智之 (愛媛大/阪大)

  • [S2-P19] 文書レイアウト解析モデルのEnd-to-End学習における損失関数切り替えの効果
    浅野 翔祐 (シェルパ), 赤部 晃一 (シェルパ), 小田 悠介 (シェルパ/NII-LLMC)

  • [S2-P32] VisEditBench: 視覚的指示を用いたダイアグラム編集ベンチマーク
    種口 暁人 (東北大), 斉藤 いつみ (東北大/科学大/理研), 吉田 遥音 (東北大), 鈴木 潤 (東北大/理研/NII LLMC)

  • [S2-P45] 汎用マルチモーダルLLMによるAI生成・改変画像の検知
    吉水 優里子 (NHK), 川瀬 恵 (NHK), 小西 修平 (NHK), 紺野 瑛介 (NHK), 月山 凛帆子 (NHK), 松本 英資 (NHK)

  • [S2-P47] 漸進的音声合成におけるSpeechLMからのフィードバックを用いたチャンク境界の最適化 【デモあり】
    小林 樹 (SCSK), Qin Xiuyuan (SCSK), 矢野 祐貴 (SCSK)

[17:05-18:05] ポスターセッション (3)

  • [S3-P05] 教育AIエージェントのための授業指導案データセット構築に向けて
    間瀬 なる美 (大教大)

  • [S3-P06] クロスモーダル意匠理解に向けた日本語意匠公報データセット構築とベンチマーク設計
    白田 連大 (京都工繊大), 野中 尋史 (愛工大), 延原 章平 (京都工繊大), 河野 誠也 (京都工繊大)

  • [S3-P14] 文字と質問の対応関係を保証した日本語シーンテキストVQAデータの合成と学習に向けて
    前田 航希 (科学大/NII LLMC), 岡崎 直観 (科学大/NII LLMC)

  • [S3-P15] 日本語文書を対象としたマルチモーダルRAGにおけるモダリティの影響分析
    安川 浩貴 (ドコビジ)

  • [S3-P16] MECHA-ja を用いた人間とVLMの常識理解の差の分析に向けて
    濱本 惇之介 (愛媛大/NII LLMC), 中山 功太 (NII LLMC), 徳久 良子 (愛工大/理研), 二宮 崇 (愛媛大), 岡崎 直観 (NII LLMC/科学大/産総研)

  • [S3-P17] VLMはかわいいを理解できるのか?
    木下 真里菜 (日本女子大学), 宮田 侑佳 (日本女子大学大学院), 土田 悠佳 (日本女子大学大学院), 倉光 君郎 (日本女子大学)

  • [S3-P18] 動画生成モデルにおける直喩理解と喩体の生成挙動
    王 略丞 (東大), 尾崎 慎太郎 (NAIST), 上垣外 英剛 (NAIST), 林 克彦 (東大), Kwon Jingun (CNU), 奥村 学 (科学大), 渡辺 太郎 (NAIST)

  • [S3-P19] 表の幾何的構造に基づいた段階的プロンプト設計
    川波 稜 (Sansan), 白石 卓也 (Sansan), 竹長 慎太朗 (Sansan), 内田 奏 (Sansan)

  • [S3-P22] 有機化合物の構造情報および知識情報の埋め込み相互変換に基づく分子生成モデルの開発
    坪井 一馬 (横国大理工), 松元 遊人 (横国大院理工), 小出 雄也 (横国大院理工), 五東 弘昭 (横国大院工)

  • [S3-P50] LLMを用いた授業映像の翻訳 【デモあり】
    内田 和史 (筑波大), 山元 大地 (筑波大), 梶田 楓斗 (筑波大), 西村 信頼 (筑波大), 武藤 直輝 (山梨大), 宇津呂 武仁 (筑波大), レオ チーシャン (山梨大), 西崎 博光 (山梨大)

8/18 (火): シンポジウム3日目

[10:40-11:40] ポスターセッション (4)

  • [S4-P02] 一般家庭における調理動画の安定収集を目的としたWebシステムの提案
    壁谷 宗汰 (愛工大), 徳久 良子 (愛工大/理研)

  • [S4-P14] Code2Figure: 学術論文における実装コードに基づくモデル図生成の初期検討
    川田 拓朗 (法政大/ZOZO研究所), 守田 竜梧 (RPTU & DFKI), 清水 良太郎 (ZOZO研究所), 渡邉 洸 (RPTU & DFKI), 彌冨 仁 (法政大)

  • [S4-P15] Where Do Vision-Language Models Preserve and Use Depth Information?
    陳 冠帆 (法政大), 川田 拓朗 (法政大), 守田 竜梧 (RPTU & DFKI), 北田 俊輔 (法政大), 彌冨 仁 (法政大/法政大)

  • [S4-P16] ルビはVLMの日本語文書画像理解を助けるのか?
    米山 瑛人 (愛媛大), 梶原 智之 (愛媛大/大阪大)

  • [S4-P17] Grounding Word Senses in Vision: Multimodal Word Sense Induction
    金 熙洙 (一橋), 凌 志棟 (一橋), 木山 朔 (一橋), 小町 守 (一橋)

  • [S4-P18] 視覚言語モデルと病徴属性を用いた植物病害診断手法の検討
    須藤 水基 (法政大), 畔上 達希 (法政大), 川田 拓朗 (法政大), 彌冨 仁 (法政大/法政大)

  • [S4-P19] MLLMのマルチターン対話における画像・テキスト情報統合能力の評価
    中尾 圭佑 (早大/NII LLMC), 栗田 修平 (NII/NII LLMC), 河原 大輔 (早大/NII LLMC)

  • [S4-P30] 画像生成AIにおけるキャラクター著作権侵害リスクのプロンプト・モデル・評価者別分析
    目時 大暉 (横浜市大/NII/LLMC), 森 友亮 (東大), 関根 聡 (NII/LLMC)

  • [S4-P36] SASB項目一致事例を用いたFew-shot推論の効果検証
    趙 駿鵬 (シェルパ), 遠藤 一護 (シェルパ), 神田 峻介 (シェルパ), 楢木 悠士 (シェルパ), 赤部 晃一 (シェルパ), 小田 悠介 (シェルパ/情報研)

[13:20-14:20] ポスターセッション (5)

  • [S5-P13] 発声に基づく動的な音響特徴量融合による音声感情認識
    清水 信希 (愛媛大), 濱本 惇之介 (愛媛大), 二宮 崇 (愛媛大), 後藤 功雄 (愛媛大)

  • [S5-P14] 視覚言語モデルを用いたAIエージェントによる悪質サイトの検知と警告能力の評価
    竹下 理斗 (法政), 川田 拓朗 (法政), 彌冨 仁 (法政)

  • [S5-P15] 「もったり」から「こんがり」まで、調理を感覚語で実況する
    小酒井 健真 (愛工大), 徳久 良子 (愛工大/理研)

  • [S5-P16] 画像サイズ変換を用いた視覚言語モデルに対する敵対的攻撃検出
    付 宇軒 (早大), 王 昊 (早大), 何 金松 (早大), 河原 大輔 (早大)

  • [S5-P17] 農業文書中の栽培暦を対象とした補助線描画による視覚質問応答の改善の試み
    中川 菫 (小樽商大), 木村 泰知 (小樽商大)

  • [S5-P18] 文書VQAにおける画像拡大ツールを用いた推論の性能・コスト分析
    楢木 悠士 (シェルパ), 赤部 晃一 (シェルパ), 中山 功太 (NII-LLMC), 小田 悠介 (シェルパ/NII-LLMC)

  • [S5-P19] 系列生成による古典籍くずし字認識
    小倉 甲陽 (東大), 林 克彦 (東大)

  • [S5-P20] 連続プロンプトチューニングを活用したキャラクター模倣音声対話システムの構築
    金子 拓正 (電通大), 稲葉 通将 (電通大)

  • [S5-P23] SNS等のUI画像がVLMによる生成文の文体に与える影響
    片岡 純弥 (早稲田大), 小橋 洋平 (東大)

  • [S5-P44] 自動運転制御のためのAIエージェント
    宮岡 佑弥 (慶大), 井上 正樹 (慶大)
  • [S5-P49] 画像を活用した英文ライティング支援システムの提案 【デモあり】
    宇野 和志 (愛工大), 永田 亮 (甲南大), 徳久 良子 (愛工大/理研)

(B7) 知識獲得・情報抽出 Knowledge Acquisition and Information Extraction / 19件

8/17 (月): シンポジウム2日目

[11:45-12:45] ポスターセッション (1)

  • [S1-P04] 大規模NERデータセット構築に向けた単語置換によるデータ拡張
    前川 大輔 (愛媛大), 藤井 諒 (フューチャー), 森下 睦 (フューチャー), 梶原 智之 (愛媛大/阪大)

  • [S1-P07] 生成AIはプランニングできるのか? ― 暗黙知を含む料理タスクのシングル/マルチタスク生成 ―
    十津 梨治句 (愛工大), 徳久 良子 (愛工大/理研)

  • [S1-P20] LLMが自動構築した知識グラフの構築品質と検索有効性の分析
    水野 多加雄 (FRAIM), 狩野 芳伸 (静大)

  • [S1-P21] 実テキストを参照した多様なLLMデータ拡張
    平松 優弥 (豊田工大), 井田 龍希 (豊田工大), 三輪 誠 (豊田工大)

  • [S1-P41] LLMの長期記憶における記憶手法の情報損失分析
    坂本 拓優 (電大)

  • [S1-P42] Do Clarification Questions Help? A Real-World Case Study on Underspecified Customer-Support QA
    Zhang Zizheng (マネーフォワード), 貞光 九月 (マネーフォワード)

[14:25-15:25] ポスターセッション (2)

  • [S2-P04] 校正・校閲データセット構築に向けた記事編集者の指摘情報に対する誤り分類
    岩本 和真 (日経), 白井 穂乃 (日経)

  • [S2-P13] 音声対話システムにおける未知語獲得のための音節認識確信度を用いた不要な聞き返し抑制
    古田 拓己 (産研), 武田 龍 (産研), 駒谷 和範 (産研)

  • [S2-P20] RAG出力に対するユーザー事実確認支援のためのタイプ別フレーズ根拠提示
    松本 悠太 (VAIABLE), Zhang Zizheng (マネーフォワード), 貞光 九月 (VAIABLE/マネーフォワード)

[17:05-18:05] ポスターセッション (3)

  • [S3-P19] 表の幾何的構造に基づいた段階的プロンプト設計
    川波 稜 (Sansan), 白石 卓也 (Sansan), 竹長 慎太朗 (Sansan), 内田 奏 (Sansan)

  • [S3-P20] LLMによる経費精算ルールの自動適応
    王 悦綸 (マネーフォワード), 山岸 駿秀 (マネーフォワード), 貞光 九月 (マネーフォワード)

  • [S3-P21] 法規・規格文書の参照構造を考慮した知識グラフデータセットと構築基準の検討
    阿部 貴駿 (北大), 松藤 彰宏 (パナソニックエレクトリックワークス), 廣瀬 良文 (パナソニックエレクトリックワークス), 平山 大世 (北大), 坂地 泰紀 (北大), 野田 五十樹 (北大)

8/18 (火): シンポジウム3日目

[10:40-11:40] ポスターセッション (4)

  • [S4-P20] LLMへのESG開示関連情報の付与はESGレポートのコンプライアンスチェックに役立つか?
    解良 智紀 (一橋大), 関 洋平 (筑波大), 中尾 悠利子 (関大), 高村 大也 (産総研), 欅 惇志 (一橋大)

  • [S4-P21] オンライン掲示板からの医薬品副作用・不適正使用情報の抽出
    萩原 茂親 (NAIST), 戴 寧 (NAIST), 西山 智弘 (NAIST), 若宮 翔子 (NAIST), 荒牧 英治 (NAIST)

[13:20-14:20] ポスターセッション (5)

  • [S5-P04] 機密情報検知を目的とした日本語NERスキーマの提案とデータセットの構築
    髙橋 遼 (Acompany), 小林 滉河 (Acompany), 平岡 拓海 (Acompany)

  • [S5-P19] 系列生成による古典籍くずし字認識
    小倉 甲陽 (東大), 林 克彦 (東大)

  • [S5-P21] Knowledge Homophilyに基づく近傍知識を用いた介入がロングテール知識の想起に与える影響の分析
    板井 孝樹 (SB Intuitions), 奥山 陽平 (SB Intuitions), 平子 潤 (SB Intuitions), 廣淵 亮太 (SB Intuitions)

  • [S5-P24] 損失曲面のSharpnessに着目した継続SFT初期値の探索
    杉本 陽大 (東北大), 矢野 一樹 (東北大), 鈴木 潤 (東北大/理研/NII LLMC)

  • [S5-P40] LLMによる属性・行動の関連付けに基づくユーザーベクトル生成 ―日経電子版を対象として―
    田村 匠 (日経), 酒井 優行 (日経), 大島 拓人 (日経)

(B8) 機械学習 Machine Learning / 27件

8/17 (月): シンポジウム2日目

[11:45-12:45] ポスターセッション (1)

  • [S1-P22] 長期タスクにおけるLLMエージェントの自律的文脈管理能力の学習
    Kumdee Thanasan (Science Tokyo), 馬 尤咪 (Science Tokyo), 岡崎 直観 (Science Tokyo/産総研/NII LLMC)

  • [S1-P32] タスクベクトルは説明可能かつ制御可能な成分に線型分解できる
    堀場 幸也 (慶大), 趙 羽風 (理研/東北大), 矢向 高弘 (慶大)

[14:25-15:25] ポスターセッション (2)

  • [S2-P11] 生成過程の段階的分解によるフロー言語モデルの品質改善
    大塚 雄貴 (科学大), 大葉 大輔 (科学大), 岡崎 直観 (科学大/産総研/NII LLMC)

  • [S2-P19] 文書レイアウト解析モデルのEnd-to-End学習における損失関数切り替えの効果
    浅野 翔祐 (シェルパ), 赤部 晃一 (シェルパ), 小田 悠介 (シェルパ/NII-LLMC)

  • [S2-P21] 自己進化型強化学習における良いサンプルとは何か?
    宮本 空 (科学大), 大葉 大輔 (科学大), 小池 隆斗 (科学大), 大井 聖也 (科学大), 岡崎 直観 (科学大/産総研/NIILLMC)

  • [S2-P28] ドロップアウト率は実モデル群の出力多様性を再現できるか
    剱持 壮吾 (理科大), 松崎 拓也 (理科大)

  • [S2-P35] 行動認識モデルの手話継続事前学習
    宇野 駿希 (豊田工大), 三輪 誠 (豊田工大)

  • [S2-P44] 数値指示によるゲームLLMエージェントの強さとプレイスタイルの制御
    坂本 充生 (サイバーエージェント), 阿部 拳之 (サイバーエージェント), 陣内 佑 (サイバーエージェント), 蟻生 開人 (サイバーエージェント)

  • [S2-P49] 事後学習による相対評価性能の向上は、ユーモア理解能力の改善を意味するのか? 【デモあり】
    伊藤 大陽 (一橋大), 金 輝燦 (一橋大), 平澤 寅庄 (一橋大), 小町 守 (一橋大)

[17:05-18:05] ポスターセッション (3)

  • [S3-P11] 句を考慮したマスク拡散言語モデル
    山内 大暉 (豊田工大), 三輪 誠 (豊田工大)

  • [S3-P12] 前臨床期アルツハイマー病検出に向けた高齢者自由会話音声認識の検討
    種村 圭師 (愛県大), 坪倉 和哉 (愛県大), 入部 百合絵 (愛県大), 北岡 教英 (豊橋技科大)

  • [S3-P22] 有機化合物の構造情報および知識情報の埋め込み相互変換に基づく分子生成モデルの開発
    坪井 一馬 (横国大理工), 松元 遊人 (横国大院理工), 小出 雄也 (横国大院理工), 五東 弘昭 (横国大院工)

  • [S3-P23] トークン単位のメモリを備えた離散拡散言語モデル
    樫森 信平 (豊田工大), 三輪 誠 (豊田工大)

  • [S3-P34] 音楽基盤モデルは音高情報を螺旋構造に埋め込む
    八木 颯斗 (慶大), 高道 慎之介 (慶大/東大), 佐藤 りん (早大), 田中 啓太郎 (早大), 森島 繁生 (早大)

  • [S3-P36] 単体複体を用いた言語モデルの出力空間の幾何的解釈
    石峯 拓海 (東大/国語研), 日野 英逸 (統数研/総研大), 横井 祥 (国語研/東北大学/理研/総研大)

  • [S3-P38] パラメータ空間の幾何構造から見るタスク算術の失敗
    李 宰成 (総研大/国語研), 中石 海 (国語研/理研), 唐木田 亮 (国語研/理研/産総研/科学大), 横井 祥 (総研大/国語研/理研/東北大)

8/18 (火): シンポジウム3日目

[10:40-11:40] ポスターセッション (4)

  • [S4-P07] Neural KWIC:KWIC 形式用例からの動的単語埋め込みの獲得と可視化
    島田 真緒 (一橋大), 木山 朔 (一橋大), 凌 志棟 (一橋大), 小町 守 (一橋大), 小木曽 智信 (国語研), 高村 大也 (産総研), 持橋 大地 (国語研/統数研)

  • [S4-P09] 依存構造木に基づく拡散言語モデルのマスク過程制御
    大畑 綾音 (豊田工大), 三輪 誠 (豊田工大)

  • [S4-P22] 自然言語タスク指示に基づく信号時相論理仕様を用いた自律移動ロボットの制御
    芹澤 和伸 (阪大), 橋本 和宗 (阪大)

  • [S4-P23] 部分空間に制約したCMA-ESによるLLMの事後学習の初期検討
    久保田 健太 (北大), 藤後 廉 (北大), 前田 圭介 (北大), 小川 貴弘 (北大), 長谷山 美紀 (北大)

  • [S4-P33] 大規模言語モデルにおける文内Attentionメカニズムの分析
    鴨田 豪 (総研大/国語研), 窪田 悠介 (総研大/国語研), 横井 祥 (総研大/国語研/東北大/理研)

  • [S4-P34] 推論型LLMの事後学習におけるタスク間干渉の解明
    宇野 真弘 (科学大), 馬 尤咪 (科学大), 岡崎 直観 (科学大/産総研/LLM研究開発センター)

  • [S4-P48] 牛舎内音声を用いた教師なし異常検知手法の検討 【デモあり】
    寺尾 瑠真 (愛県大), 坪倉 和哉 (愛県大), 神谷 咲月 (農総試), 小島 秀介 (農総試), 兒嶋 朋貴 (農研機構), 入部 百合絵 (愛県大)

[13:20-14:20] ポスターセッション (5)

  • [S5-P03] 多角的なアノテーター間依存を考慮した観点別ラベル推定の効率化
    小林 稜馬 (北大), 李 吉屹 (北大)

  • [S5-P10] Diagnosing Dialect Bias in Whisper ASR across Korean and Mandarin
    LIM DONGHUI (科学大/Hanyang Univ.), 岡崎 直観 (科学大), 馬 尤咪 (科学大)

  • [S5-P22] 進化戦略によるLLM最適化における破滅的忘却の抑制:GRPO由来パラメータマスクの導入
    福田 創 (早大), 河原 大輔 (早大)

  • [S5-P43] 個人差を考慮した対話ドメインにおける話者の主観的評価の推定
    三浦 拓人 (JAIST), 白井 清昭 (JAIST)

(B9) LLM構築 LLM Development / 19件

8/17 (月): シンポジウム2日目

[11:45-12:45] ポスターセッション (1)

  • [S1-P22] 長期タスクにおけるLLMエージェントの自律的文脈管理能力の学習
    Kumdee Thanasan (Science Tokyo), 馬 尤咪 (Science Tokyo), 岡崎 直観 (Science Tokyo/産総研/NII LLMC)

  • [S1-P23] 小規模(ローカル)LLMは競技クイズを作れるか? 解答制約と外部検索によるハルシネーション抑制と評価の課題
    井上 智弘 (佐大)

  • [S1-P24] 異なる語彙を持つ LLM 間のオンポリシ蒸留
    木村 優介 (JST/名大/同大), 駒水 孝裕 (名大), 波多野 賢治 (同大), 石川 佳治 (名大)

  • [S1-P33] LLM最終隠れ層での急激な変化の要因と影響
    柴田 圭悟 (東北大), 小林 颯介 (東北大), 高瀬 翔 (東北大), 矢野 一樹 (東北大), リュウ センペイ (SB Intuitions), 鈴木 潤 (東北大)

[14:25-15:25] ポスターセッション (2)

  • [S2-P14] 複数のスポーツ競技映像と実況テキスト対が視覚言語モデルの性能に与える影響
    島野 雄貴 (NHK), 熊野 正 (NHK)

  • [S2-P21] 自己進化型強化学習における良いサンプルとは何か?
    宮本 空 (科学大), 大葉 大輔 (科学大), 小池 隆斗 (科学大), 大井 聖也 (科学大), 岡崎 直観 (科学大/産総研/NIILLMC)

  • [S2-P22] 自動分析エージェントの構築に向けた思考経路の拡張に基づくLLMの思考言語の制御
    三橋 亮太 (サイバーエージェント)

  • [S2-P23] JFBench: 実務レベルの日本語指示追従性能を備えた生成AIを目指して
    今村 秀明 (PFN)

  • [S2-P34] SFTによって形成される内部表現の変化は、エンティティ中心学習とスキル中心学習でどう異なるか
    大田 眞滉 (愛工大), 徳久 良子 (愛工大/理研)

[17:05-18:05] ポスターセッション (3)

  • [S3-P24] 層間共有による層位置に依存したFFNのパラメータ不均一配置アーキテクチャの効果検証
    池田 航 (東北大), 柴田 圭悟 (東北大), 矢野 一樹 (東北大), 高橋 良允 (東北大), 鈴木 潤 (東北大/理研/NII LLMC)

  • [S3-P46] Webエージェントのタスク遂行を阻害するWebサイト特性の帰納的分析
    山﨑 善啓 (NTT), 北条 伸克 (NTT), 鈴木 啓太 (NTT), 小篭 蒼 (NTT), 三浦 大和 (NTT), 西田 京介 (NTT)

  • [S3-P48] nanochat-jp: 小規模日本語特化言語モデル統合研究基盤 【デモあり】
    工藤 慧音 (東北大/理研), 山口 健史 (理研), 坂口 慶祐 (東北大/理研)

8/18 (火): シンポジウム3日目

[10:40-11:40] ポスターセッション (4)

  • [S4-P23] 部分空間に制約したCMA-ESによるLLMの事後学習の初期検討
    久保田 健太 (北大), 藤後 廉 (北大), 前田 圭介 (北大), 小川 貴弘 (北大), 長谷山 美紀 (北大)

  • [S4-P24] Leveraging the multi-script Japanese writing system to apply the SpaceByte architecture
    波山 慎子 (奈女大), 須藤 克仁 (奈女大)

  • [S4-P38] plamo-3-translate: 翻訳特化LLMの開発
    鈴木 海渡 (PFN), 今城 健太郎 (PFN)

  • [S4-P47] 事前学習コーパスの栄養成分表示 【デモあり】
    源 怜維 (早大/LLMC), 藤田 一颯 (早大/LLMC), 清丸 寛一 (LLMC), 小田 悠介 (LLMC), 児玉 貴志 (LLMC), 河原 大輔 (早大/LLMC)

[13:20-14:20] ポスターセッション (5)

  • [S5-P01] 対話(たいわ)におけるLLMの漢字(かんじ)読(よ)み能⼒(のうりょく)の評価(ひょうか)
    青野 広太郎 (SB Int), 髙山 隼矢 (SB Int)

  • [S5-P23] SNS等のUI画像がVLMによる生成文の文体に与える影響
    片岡 純弥 (早稲田大), 小橋 洋平 (東大)

  • [S5-P24] 損失曲面のSharpnessに着目した継続SFT初期値の探索
    杉本 陽大 (東北大), 矢野 一樹 (東北大), 鈴木 潤 (東北大/理研/NII LLMC)

(B10) NLPモデルの評価・安全性・信頼性 Evaluation, Safety, and Reliability of NLP Models / 65件

8/17 (月): シンポジウム2日目

[11:45-12:45] ポスターセッション (1)

  • [S1-P01] AIエージェントのためのツール呼び出し評価データJMultiWOZ-TCの構築
    清水 綾太 (愛工大/NII LLMC), 中山 功太 (NII LLMC), 守山 慧 (東大/NII LLMC), 徳久 良子 (愛工大/理研), 宮尾 雄介 (東大/NII LLMC)

  • [S1-P18] 図表解像度に着目したVLMのハルシネーション傾向の分析
    根本 さくら (日本女子大学), 土田 悠佳 (日本女子大学大学院), 宮田 侑佳 (日本女子大学大学院), 倉光 君郎 (日本女子大学)

  • [S1-P25] 汎用テキスト評価モデル構築に向けた評価観点の自律的選択能力の検証
    田中 杏 (お茶大), 小林 一郎 (お茶大)

  • [S1-P26] オチ(punchline)あるいはtwist ending型物語を対象としたLLMによる結末理解の説明タスク
    程 嘉実 (筑波大), 宇津呂 武仁 (筑波大)

  • [S1-P27] 日本語文章の道徳的判断における人間とLLMの情報要求量の差異分析
    伊藤 達也 (法政), 大橋 巧 (法政), 彌冨 仁 (法政)

  • [S1-P28] 入力テキストとのアライメントを提供するハルシネーションスパン検出手法
    山田 美優 (科学大), 荒瀬 由紀 (科学大)

  • [S1-P29] 子どもにとって安全なLLMとは?〜想定応答に対する人手評価とLLM-as-a-judgeの比較分析〜
    野村 瑛吉 (横国大), 杉山 弘晃 (AISI), 黒田 麻衣子 (山陽学園大), 清水 良太郎 (早大), 高橋 史 (信州大), 高見 享佑 (大教大), 安藤 祐介 (みんなのコード), 中山 功太 (NII LLMC), 森 辰則 (横国大)

  • [S1-P30] 一様拡散言語モデルの能力獲得過程
    佐々木 睦史 (東北大), 葉 夢宇 (東北大), 趙 羽風 (理研), 工藤 慧音 (東北大/理研), 坂口 慶祐 (東北大/理研), 鈴木 潤 (東北大/理研/NII LLMC)

  • [S1-P31] Perplexityによるカットオフ推定値は何を反映しているか ― 学習データからの検証
    山下 果凜 (日本女子大), 西潟 優羽 (日本女子大), 倉光 君郎 (日本女子大)

  • [S1-P48] 形態素トークナイザーの効果検証に向けた日本語エンティティ追跡ベンチマークの構築 【デモあり】
    舘 健太朗 (愛県大), 坪倉 和哉 (愛県大), 入部 百合絵 (愛県大)

[14:25-15:25] ポスターセッション (2)

  • [S2-P01] 日本語エージェントベンチマーク「J-tau」の構築
    矢野 千紘 (SB Intuitions/名大), 平子 潤 (SB Intuitions), 廣淵 亮太 (SB Intuitions)

  • [S2-P23] JFBench: 実務レベルの日本語指示追従性能を備えた生成AIを目指して
    今村 秀明 (PFN)

  • [S2-P24] LLM-as-a-Judgeにおけるリッカート評価とランキング評価の比較分析
    松田 翔汰 (東北大), 柴田 圭悟 (東北大), 津田 純花 (東北大), 有川 透矢 (東北大), クェク ヨン シン (東北大), 池田 航 (東北大), 齋藤 由佳 (東北大), 種口 暁人 (東北大), 松田 陵佑 (東北大), 赤間 怜奈 (東北大/理研/国語研), 鈴木 潤 (東北大/理研/NII LLMC)

  • [S2-P25] 自己生成少数例の事前選択による LLM 安全性忘却の防止
    森田 知颯 (東大), 鶴岡 慶雅 (東大)

  • [S2-P26] 検証拡張生成: LLM 応答の真偽検証結果に基づく再生成
    政野 美和 (一橋大/NII LLMC), 欅 惇志 (一橋大), 欅 リベカ (東京工科大), 市岡 奨平 (一橋大/NII LLMC), 河原 大輔 (NII LLMC/早大)

  • [S2-P27] 言語モデルは文脈に依存する個人情報を検知できるのか
    西潟 優羽 (日本女子大), 山下 果凜 (日本女子大), 倉光 君郎 (日本女子大)

  • [S2-P28] ドロップアウト率は実モデル群の出力多様性を再現できるか
    剱持 壮吾 (理科大), 松崎 拓也 (理科大)

  • [S2-P29] LLMは専門知識を正しくコードに実装できるのか?
    間部 永理奈 (日本女子大)

  • [S2-P33] マルチホップQAにおけるLLMの中間概念想起の分析
    友成 光 (日立), 永塚 光一 (日立)

  • [S2-P37] 大規模言語モデルの商品推薦における説明文最適化の性能評価
    館林 裕太 (武蔵野大工)

  • [S2-P38] 大規模言語モデルによる個人特化感情分析の性能評価
    花房 健太郎 (愛媛大), 前川 大輔 (愛媛大), 梶原 智之 (愛媛大/阪大)

  • [S2-P41] ワードウルフにおける対話戦略と単語推定過程の分析
    松垣 颯夏 (愛県大), 西尾 琉惺 (愛県大), 鈴木 丈慈 (愛県大), 黒古 歩希 (愛県大), 大橋 玲音 (愛県大), 坪倉 和哉 (愛県大), 小林 邦和 (愛県大)

  • [S2-P49] 事後学習による相対評価性能の向上は、ユーモア理解能力の改善を意味するのか? 【デモあり】
    伊藤 大陽 (一橋大), 金 輝燦 (一橋大), 平澤 寅庄 (一橋大), 小町 守 (一橋大)

[17:05-18:05] ポスターセッション (3)

  • [S3-P17] VLMはかわいいを理解できるのか?
    木下 真里菜 (日本女子大学), 宮田 侑佳 (日本女子大学大学院), 土田 悠佳 (日本女子大学大学院), 倉光 君郎 (日本女子大学)

  • [S3-P25] 誹謗中傷文出力に対するJailbreakリスクに論理式プロンプトが与える影響の分析
    加藤 郁花 (横浜国大), 佐藤 心 (横浜国大), 石川 凌 (横浜国大), 野澤 遼太郎 (横浜国大), 高田 尚輝 (横浜国大), 森 辰則 (横浜国大)

  • [S3-P26] LLMの誤謬検知は不当な説得による判断変化を防ぐのか:誤謬検知の内部表現とベクトル介入
    上原 慧大 (横浜国大), 村山 太一 (横浜国大)

  • [S3-P27] チャットテンプレートの差異がLLMの性能評価に与える影響の統計的分析
    クェク ヨン シン (東北大), 種口 暁人 (東北大), 松田 陵佑 (東北大), 有川 透矢 (東北大), 松田 翔汰 (東北大), 池田 航 (東北大), 柴田 圭悟 (東北大), 津田 純花 (東北大), 齋藤 由佳 (東北大), 赤間 怜奈 (東北大/理研/国語研), 鈴木 潤 (東北大/理研/NII LLMC)

  • [S3-P28] 日本語対話環境におけるECエージェントの信頼性評価ベンチマーク
    二宮 大空 (CyberAgent)

  • [S3-P29] マルチターン対話の安全性は言語と文化のどちらに依存するのか?日本語と英語の比較研究
    五十里 渚 (早大), 福田 創 (早大), 高山 隼矢 (SB Intuitions), 綿岡 晃輝 (SB Intuitions), 河原 大輔 (早大)

  • [S3-P30] 有害カテゴリのマルチラベルデータセットの構築とカテゴリ間相互作用の分析
    北村 有彩 (一橋大), 佐藤 祥太 (一橋大), 小町 守 (一橋大), 鈴木 久美 (NII LLMC), 欅 惇志 (一橋大)

  • [S3-P31] LLMは邪馬台国論争の論文をどう評価するのか?
    前原 茜 (日本女子大), 森部 七海 (日本女子大), 西潟 優羽 (日本女子大), 倉光 君郎 (日本女子大)

  • [S3-P32] LLM内部表現における予測可能成分と新規成分の分析
    関口 正登 (電大), 前田 英作 (電大)

  • [S3-P33] 対数尤度で捉えるLLMの流行シグナル
    長井 夢歩 (日本女子大), 山下 果凛 (日本女子大), 長谷川 愛珠 (日本女子大), 西潟 優羽 (日本女子大), 倉光 君郎 (日本女子大)

  • [S3-P35] LLM推論における内部表現を用いたヒント妥当性の推定と選択的介入
    峯村 祥生 (東大), 浅野 輝 (東大), 馬場 雪乃 (東大)

  • [S3-P42] LLMは話し言葉と書き言葉を何で区別しているのか ― BERT埋め込みと構成要件に基づく分析 ―
    森貞 堅湧 (新居浜高専), 田窪 洋介 (新居浜高専), 高品 良 (APTO), 狩野 洋一 (APTO), Jeongmyeong Lee (APTO)

8/18 (火): シンポジウム3日目

[10:40-11:40] ポスターセッション (4)

  • [S4-P06] AnaToMを用いた大規模言語モデルの心の理論に関する詳細分析
    Lee JungHoon (電大), 前田 英作 (電大)

  • [S4-P19] MLLMのマルチターン対話における画像・テキスト情報統合能力の評価
    中尾 圭佑 (早大/NII LLMC), 栗田 修平 (NII/NII LLMC), 河原 大輔 (早大/NII LLMC)

  • [S4-P25] コンテキスト設計でLLM脆弱性診断は向上するか?
    長谷川 愛珠 (本女), 森部 七海 (本女), 山下 果凜 (本女), 倉光 君郎 (本女)

  • [S4-P26] 多言語LLMの政治的回答分布は国別意見分布と一致するかーCSESを用いた比較分析ー
    植田 雄士 (奈良先端大), 上田 健太郎 (奈良先端大), 鳥海 不二夫 (東大), 荒川 豊 (九大), 安本 慶一 (奈良先端大), 諏訪 博彦 (奈良先端大)

  • [S4-P27] LLMの日本語音象徴理解を測るベンチマーク構築にむけた検討
    三浦 秀隆 (慶大), 深尾 貫太 (慶大), 清水 周一郎 (慶大), 高道 慎之介 (慶大/東大)

  • [S4-P28] 日本の有権者ペルソナからLLMが生成する友人ネットワークの検証
    高柳 慶太郎 (京大), 廣中 詩織 (京大), 首藤 一幸 (京大)

  • [S4-P29] LLMは「日本語のゆれ」に対する日本語話者の容認度を再現するか
    高山 隼矢 (SB Intuitions)

  • [S4-P30] 画像生成AIにおけるキャラクター著作権侵害リスクのプロンプト・モデル・評価者別分析
    目時 大暉 (横浜市大/NII/LLMC), 森 友亮 (東大), 関根 聡 (NII/LLMC)

  • [S4-P31] 多言語LLMにおける知識想起は言語非依存の潜在空間で行われるか
    手塚 陽大 (JAIST), 北島 祥平 (JAIST), 大西 直 (JAIST/松尾研究所), 井之上 直也 (JAIST/理研)

  • [S4-P32] 大規模言語モデルにおけるモデル内知識の論理整合性の診断的評価
    北島 祥平 (JAIST), 井之上 直也 (JAIST), 手塚 陽大 (JAIST), 大西 直 (JAIST/松尾研究所)

  • [S4-P35] Feed-Forward Network への介入が長回答生成に与える影響
    村田 圭翼 (一橋大), 山田 寛章 (都立大), 欅 惇志 (一橋大)

  • [S4-P43] タスク指向対話におけるLLMエージェントの「気遣い」の能力を測るベンチマークの構築
    勝見 久央 (NTT/阪大), 吉野 幸一郎 (阪大), 水上 雅博 (NTT), 西田 京介 (NTT)

  • [S4-P44] Toward a Japanese Office-Task Agent Benchmark: A Preliminary Localization of OdysseyBench
    Su Myat Noe (特任研究員, 国立情報学研究所 大規模言語モデル研究開発センター), 功太 中山 (特任研究員, 国立情報学研究所 大規模言語モデル研究開発センター), Yunang Wu (特任研究員, 国立情報学研究所 大規模言語モデル研究開発センター)

  • [S4-P49] LLM-as-a-Judgeを用いた金融ニュース因果関係説明生成の評価 【デモあり】
    謝 宇程 (筑波大), 小齋 友里菜 (筑波大), 土田 陸斗 (筑波大), 宇津呂 武仁 (筑波大)

[13:20-14:20] ポスターセッション (5)

  • [S5-P07] 「掻痒」は「そう痒」より伝わるのか? ―医療用語における漢字表記の理解可能性の検討―
    倉本 真菜 (奈良先端大), 永井 宥之 (奈良先端大), 西山 智弘 (奈良先端大), 若宮 翔子 (奈良先端大), 荒牧 英治 (奈良先端大)

  • [S5-P09] 拡散言語モデルの社会的バイアスに与えるサンプリング設定の影響
    齋藤 幸史郎 (科学大), 大葉 大輔 (科学大), Bollegala Danushka (UoL), 岡崎 直観 (科学大/産総研/NII LLMC)

  • [S5-P14] 視覚言語モデルを用いたAIエージェントによる悪質サイトの検知と警告能力の評価
    竹下 理斗 (法政), 川田 拓朗 (法政), 彌冨 仁 (法政)

  • [S5-P25] 税理士試験とフロンティアモデル
    小野 克樹 (VAIABLE), 佐原 恭平 (VAIABLE/京大), 貞光 九月 (VAIABLE)

  • [S5-P26] 文化的に潜在化したメンタルヘルスリスクに対するLLM応答の安全性評価ベンチマークの構築
    嵐 大樹 (奈良医大), 久田 祥平 (NAIST), 折茂 圭介 (Ubie), 太田 満久 (Ubie), 風間 正弘 (Ubie), 五十嵐 健史 (Ubie), 荒牧 英治 (NAIST)

  • [S5-P27] 年代別評価データにおける大規模言語モデルの性能差の検出力分析
    有川 透矢 (東北大), 池田 航 (東北大), 齋藤 由佳 (東北大), 松田 翔汰 (東北大), クェク ヨン シン (東北大), 柴田 圭悟 (東北大), 種口 暁人 (東北大), 津田 純花 (東北大), 松田 陵佑 (東北大), 赤間 怜奈 (東北大/理研/国語研), 鈴木 潤 (東北大/理研/NII LLMC)

  • [S5-P28] パーソナライズベンチマークの「正答」は何に支えられているか:判断の根拠を統制するベンチマークの設計
    須貝 優太 (横国大), 村山 太一 (横国大)

  • [S5-P29] RAGを用いた知識補完による暗黙的ヘイトスピーチ検出手法の検討
    小林 秀太郎 (科学大), 荒瀬 由紀 (科学大)

  • [S5-P30] LLMが回答を決める早さはバイアスの現れやすさと関係するか?
    安里 優真 (北陸先端大), 小田 康平 (北陸先端大), 白井 清昭 (北陸先端大), Kertkeidkachorn Natthawut (北陸先端大)

  • [S5-P31] LLM-as-a-Judgeにおける絶対評価と相対評価の整合性はスコア帯でどのように変わるか?
    山下 伊織 (一橋大), 木山 朔 (一橋大), 伊藤 大陽 (一橋大), 小町 守 (一橋大)

  • [S5-P32] 対数尤度から測るドメイン間の「高低差」は何のシグナルか?
    菊池 美咲 (日本女子大学), 山下 果凛 (日本女子大学大学院), 長谷川 愛珠 (日本女子大学大学院)

  • [S5-P34] 非頻出subjectに対するLLMの知識編集では局所性が改善するのか ―subjectのトークン化傾向に着目した分析―
    豊嶋 勇伍 (電大), 前田 英作 (電大)

  • [S5-P35] 形容詞が導く文化バイアス
    福井 優那 (金大), 平尾 努 (金大), 高村 大也 (産総研)

  • [S5-P36] 文学テキストのスパースオートエンコーダ特徴の観察:Gemma Scopeシリーズからゲーテ作品を視る
    浅間 香織 (東大)

  • [S5-P42] 対話中の感情変化と既存評価尺度の関係分析
    沼屋 征海 (東北大), 佐藤 志貴 (東北大), 守屋 彰二 (東北大), 藤井 諒 (東北大/フューチャー), 鈴木 潤 (東北大/理研/NII LLMC), 赤間 怜奈 (東北大/理研/国語研)

  • [S5-P46] 学習済みモデルを用いたAI人狼ゲームの発言タイミングの評価 【デモあり】
    加藤 もも香 (愛県大), 鈴木 丈慈 (愛県大), 大橋 玲音 (愛県大), 坪倉 和哉 (愛県大), 小林 邦和 (愛県大)

(B11) NLPモデルの解釈可能性・分析 Interpretability and Analysis of NLP Models / 47件

8/17 (月): シンポジウム2日目

[11:45-12:45] ポスターセッション (1)

  • [S1-P03] 典拠に基づいた事実性判定テストセットの構築
    田口 凜采 (豊橋技科大), 土屋 雅稔 (豊橋技科大/NICT)

  • [S1-P06] 生活者解釈と実務的規範解釈を中間表現とする広告法務審査の潜在変数モデル化に向けた検討
    石垣 龍馬 (HT), 森川 祐介 (HT)

  • [S1-P14] LLMは未知言語のコードを何語で考えているか
    森部 七海 (本女), 西潟 優羽 (本女), 宮田 侑佳 (本女), 倉光 君郎 (本女)

  • [S1-P16] CLIPにおける埋め込みのノルムは本当に捨ててよいのか?
    佐藤 祥太 (一橋), 木山 朔 (一橋), 平澤 寅庄 (一橋), 小町 守 (一橋)

  • [S1-P28] 入力テキストとのアライメントを提供するハルシネーションスパン検出手法
    山田 美優 (科学大), 荒瀬 由紀 (科学大)

  • [S1-P30] 一様拡散言語モデルの能力獲得過程
    佐々木 睦史 (東北大), 葉 夢宇 (東北大), 趙 羽風 (理研), 工藤 慧音 (東北大/理研), 坂口 慶祐 (東北大/理研), 鈴木 潤 (東北大/理研/NII LLMC)

  • [S1-P31] Perplexityによるカットオフ推定値は何を反映しているか ― 学習データからの検証
    山下 果凜 (日本女子大), 西潟 優羽 (日本女子大), 倉光 君郎 (日本女子大)

  • [S1-P32] タスクベクトルは説明可能かつ制御可能な成分に線型分解できる
    堀場 幸也 (慶大), 趙 羽風 (理研/東北大), 矢向 高弘 (慶大)

  • [S1-P33] LLM最終隠れ層での急激な変化の要因と影響
    柴田 圭悟 (東北大), 小林 颯介 (東北大), 高瀬 翔 (東北大), 矢野 一樹 (東北大), リュウ センペイ (SB Intuitions), 鈴木 潤 (東北大)

  • [S1-P34] LLMは感情強度の高いエピソードを優先して記憶するのか — 獲得・保持と想起前後の内部表現
    大西 直 (JAIST/松尾研究所), 北島 祥平 (JAIST), 手塚 陽大 (JAIST), 井之上 直也 (JAIST)

  • [S1-P35] 追加学習前後の重み差分を用いた言語モデルの学習ドメイン理解に関する自己評価
    小野 聡 (早大)

[14:25-15:25] ポスターセッション (2)

  • [S2-P15] 再帰的Transformerはデータ制約下で何に効いて何に効かないのか
    堀田 大智 (青学), 小橋 洋平 (東大), 小島 武 (東大), 岩澤 有祐 (東大), 松尾 豊 (東大)

  • [S2-P22] 自動分析エージェントの構築に向けた思考経路の拡張に基づくLLMの思考言語の制御
    三橋 亮太 (サイバーエージェント)

  • [S2-P24] LLM-as-a-Judgeにおけるリッカート評価とランキング評価の比較分析
    松田 翔汰 (東北大), 柴田 圭悟 (東北大), 津田 純花 (東北大), 有川 透矢 (東北大), クェク ヨン シン (東北大), 池田 航 (東北大), 齋藤 由佳 (東北大), 種口 暁人 (東北大), 松田 陵佑 (東北大), 赤間 怜奈 (東北大/理研/国語研), 鈴木 潤 (東北大/理研/NII LLMC)

  • [S2-P29] LLMは専門知識を正しくコードに実装できるのか?
    間部 永理奈 (日本女子大)

  • [S2-P30] Activation Steeringにおける文章崩壊の抑制に向けた初期検討
    西山 天 (法政大), 川田 拓朗 (法政大), 北田 俊輔 (法政大), 永井 大地 (法政大), 彌冨 仁 (法政大)

  • [S2-P31] Beyond Recomputation: Direct Routing as a General Information-Reuse Strategy in LLMs
    李 睿 (JAIST), 趙 羽風 (理研/東北大), 井之上 直也 (JAIST/理研)

  • [S2-P33] マルチホップQAにおけるLLMの中間概念想起の分析
    友成 光 (日立), 永塚 光一 (日立)

  • [S2-P34] SFTによって形成される内部表現の変化は、エンティティ中心学習とスキル中心学習でどう異なるか
    大田 眞滉 (愛工大), 徳久 良子 (愛工大/理研)

  • [S2-P36] 大規模言語モデルと自己修正に基づく歌唱可能な歌詞への Phonemic Translation
    阪井 瞭介 (慶大), 深尾 貫太 (慶大), 高道 慎之介 (慶大/東大)

[17:05-18:05] ポスターセッション (3)

  • [S3-P10] LLM-as-a-Judgeのフィードバックを用いた株価変動理由記事の繰り返し生成
    小齋 友里菜 (筑波大学), 土田 陸斗 (筑波大学), 謝 宇程 (筑波大学)

  • [S3-P24] 層間共有による層位置に依存したFFNのパラメータ不均一配置アーキテクチャの効果検証
    池田 航 (東北大), 柴田 圭悟 (東北大), 矢野 一樹 (東北大), 高橋 良允 (東北大), 鈴木 潤 (東北大/理研/NII LLMC)

  • [S3-P27] チャットテンプレートの差異がLLMの性能評価に与える影響の統計的分析
    クェク ヨン シン (東北大), 種口 暁人 (東北大), 松田 陵佑 (東北大), 有川 透矢 (東北大), 松田 翔汰 (東北大), 池田 航 (東北大), 柴田 圭悟 (東北大), 津田 純花 (東北大), 齋藤 由佳 (東北大), 赤間 怜奈 (東北大/理研/国語研), 鈴木 潤 (東北大/理研/NII LLMC)

  • [S3-P32] LLM内部表現における予測可能成分と新規成分の分析
    関口 正登 (電大), 前田 英作 (電大)

  • [S3-P33] 対数尤度で捉えるLLMの流行シグナル
    長井 夢歩 (日本女子大), 山下 果凛 (日本女子大), 長谷川 愛珠 (日本女子大), 西潟 優羽 (日本女子大), 倉光 君郎 (日本女子大)

  • [S3-P34] 音楽基盤モデルは音高情報を螺旋構造に埋め込む
    八木 颯斗 (慶大), 高道 慎之介 (慶大/東大), 佐藤 りん (早大), 田中 啓太郎 (早大), 森島 繁生 (早大)

  • [S3-P35] LLM推論における内部表現を用いたヒント妥当性の推定と選択的介入
    峯村 祥生 (東大), 浅野 輝 (東大), 馬場 雪乃 (東大)

  • [S3-P36] 単体複体を用いた言語モデルの出力空間の幾何的解釈
    石峯 拓海 (東大/国語研), 日野 英逸 (統数研/総研大), 横井 祥 (国語研/東北大学/理研/総研大)

8/18 (火): シンポジウム3日目

[10:40-11:40] ポスターセッション (4)

  • [S4-P16] ルビはVLMの日本語文書画像理解を助けるのか?
    米山 瑛人 (愛媛大), 梶原 智之 (愛媛大/大阪大)

  • [S4-P25] コンテキスト設計でLLM脆弱性診断は向上するか?
    長谷川 愛珠 (本女), 森部 七海 (本女), 山下 果凜 (本女), 倉光 君郎 (本女)

  • [S4-P31] 多言語LLMにおける知識想起は言語非依存の潜在空間で行われるか
    手塚 陽大 (JAIST), 北島 祥平 (JAIST), 大西 直 (JAIST/松尾研究所), 井之上 直也 (JAIST/理研)

  • [S4-P32] 大規模言語モデルにおけるモデル内知識の論理整合性の診断的評価
    北島 祥平 (JAIST), 井之上 直也 (JAIST), 手塚 陽大 (JAIST), 大西 直 (JAIST/松尾研究所)

  • [S4-P33] 大規模言語モデルにおける文内Attentionメカニズムの分析
    鴨田 豪 (総研大/国語研), 窪田 悠介 (総研大/国語研), 横井 祥 (総研大/国語研/東北大/理研)

  • [S4-P34] 推論型LLMの事後学習におけるタスク間干渉の解明
    宇野 真弘 (科学大), 馬 尤咪 (科学大), 岡崎 直観 (科学大/産総研/LLM研究開発センター)

  • [S4-P35] Feed-Forward Network への介入が長回答生成に与える影響
    村田 圭翼 (一橋大), 山田 寛章 (都立大), 欅 惇志 (一橋大)

  • [S4-P37] 大規模言語モデルにおける低資源言語の内部表現分離
    李 辰仁 (東大), 大関 洋平 (東大)

[13:20-14:20] ポスターセッション (5)

  • [S5-P21] Knowledge Homophilyに基づく近傍知識を用いた介入がロングテール知識の想起に与える影響の分析
    板井 孝樹 (SB Intuitions), 奥山 陽平 (SB Intuitions), 平子 潤 (SB Intuitions), 廣淵 亮太 (SB Intuitions)

  • [S5-P27] 年代別評価データにおける大規模言語モデルの性能差の検出力分析
    有川 透矢 (東北大), 池田 航 (東北大), 齋藤 由佳 (東北大), 松田 翔汰 (東北大), クェク ヨン シン (東北大), 柴田 圭悟 (東北大), 種口 暁人 (東北大), 津田 純花 (東北大), 松田 陵佑 (東北大), 赤間 怜奈 (東北大/理研/国語研), 鈴木 潤 (東北大/理研/NII LLMC)

  • [S5-P28] パーソナライズベンチマークの「正答」は何に支えられているか:判断の根拠を統制するベンチマークの設計
    須貝 優太 (横国大), 村山 太一 (横国大)

  • [S5-P29] RAGを用いた知識補完による暗黙的ヘイトスピーチ検出手法の検討
    小林 秀太郎 (科学大), 荒瀬 由紀 (科学大)

  • [S5-P30] LLMが回答を決める早さはバイアスの現れやすさと関係するか?
    安里 優真 (北陸先端大), 小田 康平 (北陸先端大), 白井 清昭 (北陸先端大), Kertkeidkachorn Natthawut (北陸先端大)

  • [S5-P32] 対数尤度から測るドメイン間の「高低差」は何のシグナルか?
    菊池 美咲 (日本女子大学), 山下 果凛 (日本女子大学大学院), 長谷川 愛珠 (日本女子大学大学院)

  • [S5-P33] 構文文法に基づく言語モデルの構文獲得メカニズムの分析
    九門 涼真 (東大/理研), 谷中 瞳 (東大/理研/東北大)

  • [S5-P34] 非頻出subjectに対するLLMの知識編集では局所性が改善するのか ―subjectのトークン化傾向に着目した分析―
    豊嶋 勇伍 (電大), 前田 英作 (電大)

  • [S5-P35] 形容詞が導く文化バイアス
    福井 優那 (金大), 平尾 努 (金大), 高村 大也 (産総研)

  • [S5-P36] 文学テキストのスパースオートエンコーダ特徴の観察:Gemma Scopeシリーズからゲーテ作品を視る
    浅間 香織 (東大)

  • [S5-P48] 麻雀AIの生成解説における盤面事実への忠実性と多事実列挙の限界分析 【デモあり】
    土田 蒼大 (N高/LLMATCH), 小橋 洋平 (LLMATCH/東京大学大学院工学系研究科)

(B12) NLPのための効率的/低リソース手法 Efficient/Low-Resource Methods for NLP / 15件

8/17 (月): シンポジウム2日目

[11:45-12:45] ポスターセッション (1)

  • [S1-P36] 議会会議録を対象とした適応的バッチSelf-Consistencyによる話者の役割分類
    蛇谷 祐人 (小樽商大), 木村 泰知 (小樽商大)

  • [S1-P14] LLMは未知言語のコードを何語で考えているか
    森部 七海 (本女), 西潟 優羽 (本女), 宮田 侑佳 (本女), 倉光 君郎 (本女)

[14:25-15:25] ポスターセッション (2)

  • [S2-P25] 自己生成少数例の事前選択による LLM 安全性忘却の防止
    森田 知颯 (東大), 鶴岡 慶雅 (東大)

  • [S2-P35] 行動認識モデルの手話継続事前学習
    宇野 駿希 (豊田工大), 三輪 誠 (豊田工大)

[17:05-18:05] ポスターセッション (3)

  • [S3-P37] Benchmark Construction Pathways as Measurement Variables: A Controlled Khmer Case Study
    LOEM Mengsay (PFN), LAY Kimseng (東北大)

  • [S3-P38] パラメータ空間の幾何構造から見るタスク算術の失敗
    李 宰成 (総研大/国語研), 中石 海 (国語研/理研), 唐木田 亮 (国語研/理研/産総研/科学大), 横井 祥 (総研大/国語研/理研/東北大)

  • [S3-P39] 複数プロンプト型Consensus-GRPOによる機械翻訳
    田窪 真大 (愛媛大), 西田 祥人 (愛媛大), 二宮 崇 (愛媛大), 後藤 功雄 (愛媛大)

  • [S3-P47] 音声合成モデルのパラメータ演算による任意話者の声質での方言合成 【デモあり】
    三森 俊祐 (SB Int/早大), 水本 智也 (SB Int), 藤田 雄介 (SB Int)

  • [S3-P48] nanochat-jp: 小規模日本語特化言語モデル統合研究基盤 【デモあり】
    工藤 慧音 (東北大/理研), 山口 健史 (理研), 坂口 慶祐 (東北大/理研)

8/18 (火): シンポジウム3日目

[10:40-11:40] ポスターセッション (4)

  • [S4-P36] SASB項目一致事例を用いたFew-shot推論の効果検証
    趙 駿鵬 (シェルパ), 遠藤 一護 (シェルパ), 神田 峻介 (シェルパ), 楢木 悠士 (シェルパ), 赤部 晃一 (シェルパ), 小田 悠介 (シェルパ/情報研)

  • [S4-P37] 大規模言語モデルにおける低資源言語の内部表現分離
    李 辰仁 (東大), 大関 洋平 (東大)

[13:20-14:20] ポスターセッション (5)

  • [S5-P11] Speech-Text-to-Text対話モデルにおける速度と精度のトレードオフ
    中畔 彪雅 (奈良先端大/理研/阪大), 吉野 幸一郎 (理研/阪大)

  • [S5-P22] 進化戦略によるLLM最適化における破滅的忘却の抑制:GRPO由来パラメータマスクの導入
    福田 創 (早大), 河原 大輔 (早大)

  • [S5-P37] 不均一な公開LoRAプールにおける学習なしルーティング
    和田 和浩 (エクサウィザーズ)

  • [S5-P38] 医療ドメイン文書からの教師なし時間関係グラフ生成
    田村 聡信 (科学大), 荒瀬 由紀 (科学大)

(C1) 機械翻訳 Machine translation / 8件

8/17 (月): シンポジウム2日目

[11:45-12:45] ポスターセッション (1)

  • [S1-P49] 特許請求項翻訳評価のためのルーブリックに基づくLLM-as-a-Judgeの提案 【デモあり】
    FU YINGYI (筑波大), 宇津呂 武仁 (筑波大), 永田 昌明 (CS研)

[14:25-15:25] ポスターセッション (2)

  • [S2-P36] 大規模言語モデルと自己修正に基づく歌唱可能な歌詞への Phonemic Translation
    阪井 瞭介 (慶大), 深尾 貫太 (慶大), 高道 慎之介 (慶大/東大)

[17:05-18:05] ポスターセッション (3)

  • [S3-P01] Constructing a Multilingual Parallel Corpus from Fandom Wikis: A Pokemon Case Study
    宋 玄遇 (NAIST), 尾崎 慎太郎 (NAIST), 林 和樹 (NAIST), 上垣外 英剛 (NAIST), 林 克彦 (東大), 渡辺 太郎 (NAIST)

  • [S3-P08] 複統合的言語 アイヌ語のサブワード分割 〜機械翻訳モデルに最適なトークナイザーとは〜
    中田 琉稀 (東大後期教養), 花田 佳文 (東大言語情報), 林 克彦 (東大言語情報)

  • [S3-P39] 複数プロンプト型Consensus-GRPOによる機械翻訳
    田窪 真大 (愛媛大), 西田 祥人 (愛媛大), 二宮 崇 (愛媛大), 後藤 功雄 (愛媛大)

8/18 (火): シンポジウム3日目

[10:40-11:40] ポスターセッション (4)

  • [S4-P11] Low-Resource Burmese-to-Japanese Speech Translation with LLM-Generated Data and LLM-as-Judge
    KHINE ZAR THWE (奈良先端科学技術大学院大学(NAIST)), 大内 啓樹 (奈良先端科学技術大学院大学(NAIST)), Sakti Sakriani (奈良先端科学技術大学院大学(NAIST))

  • [S4-P38] plamo-3-translate: 翻訳特化LLMの開発
    鈴木 海渡 (PFN), 今城 健太郎 (PFN)

[13:20-14:20] ポスターセッション (5)

  • [S5-P39] 機械翻訳タスクにおける日本語文書単位容認性判断データセット構築と途中補完モデル
    松田 陵佑 (東北大), 工藤 慧音 (東北大/理研), 藤井 諒 (東北大/フューチャー), 伊藤 拓海 (東北大/MLS Inc.), 森下 睦 (東北大/フューチャー), 鈴木 潤 (東北大/理研)

(C2) 情報検索・テキストマイニング Information Retrieval and Text Mining / 14件

8/17 (月): シンポジウム2日目

[11:45-12:45] ポスターセッション (1)

  • [S1-P05] オンライン記事の引用に伴う解釈変化を捉えるデータセット構築
    後藤 隆希 (横浜国大), 吉田 光男 (筑波大), 村山 太一 (横浜国大)

  • [S1-P20] LLMが自動構築した知識グラフの構築品質と検索有効性の分析
    水野 多加雄 (FRAIM), 狩野 芳伸 (静大)

  • [S1-P37] 親契約書検索のための候補選択とリランキング
    大田尾 匠 (Sansan), 橋本 航 (Sansan)

  • [S1-P47] 誤情報拡散防止を目的としたXポストへのコミュニティノート付与手法の提案 【デモあり】
    嶋津 瑛 (筑波大), 田口 雄大 (筑波大), 山本 勇太 (筑波大), 王 婧薇 (筑波大), 宇津呂 武仁 (筑波大)

[14:25-15:25] ポスターセッション (2)

  • [S2-P37] 大規模言語モデルの商品推薦における説明文最適化の性能評価
    館林 裕太 (武蔵野大工)

[17:05-18:05] ポスターセッション (3)

  • [S3-P09] 階層的な質問による解釈可能なテキスト埋め込み
    小田 康平 (JAIST), 荘 博閔 (東芝)

  • [S3-P15] 日本語文書を対象としたマルチモーダルRAGにおけるモダリティの影響分析
    安川 浩貴 (ドコビジ)

  • [S3-P40] 地方選挙におけるファクトチェック記事のソーシャルメディア上の拡散傾向の分析
    野田 陽 (朝日新聞社), 新妻 巧朗 (朝日新聞社), 田森 秀明 (朝日新聞社)

  • [S3-P41] 大規模言語モデルによる決算短信の評価と株価への情報織り込み分析
    河本 道弥 (JPSI), 多田 大 (JPSI), 源 怜維 (JPSI)

8/18 (火): シンポジウム3日目

[10:40-11:40] ポスターセッション (4)

  • [S4-P01] 事実検証ベンチマーク構築に向けた新聞訂正記事10年分の誤り分析
    山内 洋輝 (朝日新聞社), 田森 秀明 (朝日新聞社)

  • [S4-P21] オンライン掲示板からの医薬品副作用・不適正使用情報の抽出
    萩原 茂親 (NAIST), 戴 寧 (NAIST), 西山 智弘 (NAIST), 若宮 翔子 (NAIST), 荒牧 英治 (NAIST)

  • [S4-P50] 誤情報拡散防止のためのコミュニティノート作成理由生成タスクの提案 【デモあり】
    田口 雄大 (筑波大学), 山本 勇太 (筑波大学), 嶋津 瑛 (筑波大学), 王 婧薇 (筑波大学), 宇津呂 武仁 (筑波大学)

[13:20-14:20] ポスターセッション (5)

  • [S5-P40] LLMによる属性・行動の関連付けに基づくユーザーベクトル生成 ―日経電子版を対象として―
    田村 匠 (日経), 酒井 優行 (日経), 大島 拓人 (日経)

  • [S5-P45] 誤情報拡散防止のためのコミュニティノート収集およびデータセット作成 【デモあり】
    山本 勇太 (筑波大), 田口 雄大 (筑波大), 嶋津 瑛 (筑波大), 王 婧薇 (筑波大), 宇津呂 武仁 (筑波大)

(C3) 評判・感情分析,スタイル分析 Sentiment Analysis, Style Analysis / 16件

8/17 (月): シンポジウム2日目

[11:45-12:45] ポスターセッション (1)

  • [S1-P34] LLMは感情強度の高いエピソードを優先して記憶するのか — 獲得・保持と想起前後の内部表現
    大西 直 (JAIST/松尾研究所), 北島 祥平 (JAIST), 手塚 陽大 (JAIST), 井之上 直也 (JAIST)

  • [S1-P38] 選挙情報空間におけるクリックベイト的表現の効果:2025年参院選YouTube動画の傾向スコアマッチング分析
    中村 響 (東大), 伊藤 和浩 (東大), 太田 光紀 (東大), 鳥海 不二夫 (東大)

  • [S1-P39] J-RhymeDetector: 日本語ラップにおける押韻スパン検出モデルの構築
    小川 隼斗 (早大), 河原 大輔 (早大)

[14:25-15:25] ポスターセッション (2)

  • [S2-P08] 現代日本語短歌における脳内感情処理機構の解明へ向けて
    黒川 真琳 (お茶大), 持橋 大地 (統数研/国語研), 小林 一郎 (お茶大)

  • [S2-P38] 大規模言語モデルによる個人特化感情分析の性能評価
    花房 健太郎 (愛媛大), 前川 大輔 (愛媛大), 梶原 智之 (愛媛大/阪大)

  • [S2-P39] 対話における話者本人の心情を第三者はどこまで推測できるか
    田中 義規 (電通大), 井上 昂治 (京大), 稲葉 通将 (電通大)

[17:05-18:05] ポスターセッション (3)

  • [S3-P40] 地方選挙におけるファクトチェック記事のソーシャルメディア上の拡散傾向の分析
    野田 陽 (朝日新聞社), 新妻 巧朗 (朝日新聞社), 田森 秀明 (朝日新聞社)

  • [S3-P42] LLMは話し言葉と書き言葉を何で区別しているのか ― BERT埋め込みと構成要件に基づく分析 ―
    森貞 堅湧 (新居浜高専), 田窪 洋介 (新居浜高専), 高品 良 (APTO), 狩野 洋一 (APTO), Jeongmyeong Lee (APTO)

  • [S3-P45] 出来事に基づく認知症介護者の自然文感情予測におけるLLMの比較評価
    白川 桃子 (武蔵野大工), 佐々木 多希子 (武蔵野大工)

  • [S3-P49] 性格付けされた対話システムを実現するための適応的ステアリングによる大規模言語モデルの応答制御
    山上 藍稀 (JAIST)

8/18 (火): シンポジウム3日目

[10:40-11:40] ポスターセッション (4)

  • [S4-P08] 大規模言語モデルを用いた相談型掲示板の回答意図推定
    羽鳥 なの香 (青学), 横山 暁 (青学)

  • [S4-P39] ニュース記事に対する読者感情分布の推定に向けて
    山口 哲平 (愛媛大), 花房 健太郎 (愛媛大), 近藤 里咲 (愛媛大), 梶原 智之 (愛媛大/阪大), 早志 英朗 (阪大), 中島 悠太 (阪大), 長原 一 (阪大)

  • [S4-P41] 対話における登場人物の感情の理解と活用に向けて
    小山 将生 (愛媛大), 近藤 里咲 (愛媛大), 高山 隼矢 (愛媛大), 梶原 智之 (愛媛大/阪大)

[13:20-14:20] ポスターセッション (5)

  • [S5-P06] サプライザルは表記選好と逆相関する
    山口 美咲 (東大), 三田 雅人 (東大), 磯野 真之介 (国語研), 大関 洋平 (東大/NII)

  • [S5-P41] キャラクター発話文埋め込みの意味とスタイルの分離に向けて
    近藤 里咲 (愛媛大), 梶原 智之 (愛媛大/阪大)

  • [S5-P42] 対話中の感情変化と既存評価尺度の関係分析
    沼屋 征海 (東北大), 佐藤 志貴 (東北大), 守屋 彰二 (東北大), 藤井 諒 (東北大/フューチャー), 鈴木 潤 (東北大/理研/NII LLMC), 赤間 怜奈 (東北大/理研/国語研)

(C4) 対話 Dialogue / 25件

8/17 (月): シンポジウム2日目

[11:45-12:45] ポスターセッション (1)

  • [S1-P10] 「今一度」より「今井ちど」? 意図的な誤字プロンプトによるTTSの調整
    千頭和 翔悟 (IVRy/慶応大), 吉田 快 (IVRy), 町田 雄一郎 (IVRy)

  • [S1-P40] 笑い声先読みに基づくプロアクティブ対話システム
    内山 大希 (科学大)

  • [S1-P41] LLMの長期記憶における記憶手法の情報損失分析
    坂本 拓優 (電大)

  • [S1-P50] 運転負荷に合わせた音声対話システム 【デモあり】
    新垣 嘉成太 (愛工大), 徳久 良子 (愛工大/理研)

[14:25-15:25] ポスターセッション (2)

  • [S2-P12] 質問駆動型の情報抽出による将棋AI指し手の対話的解説生成
    大原 蒼生 (理科大)

  • [S2-P39] 対話における話者本人の心情を第三者はどこまで推測できるか
    田中 義規 (電通大), 井上 昂治 (京大), 稲葉 通将 (電通大)

  • [S2-P40] 音声対話における発話タイミング予測
    大西 一誉 (奈良先端/理研/阪大), 大中 緋慧 (奈良先端/理研), 吉野 幸一郎 (奈良先端/理研/阪大/科学大)

  • [S2-P41] ワードウルフにおける対話戦略と単語推定過程の分析
    松垣 颯夏 (愛県大), 西尾 琉惺 (愛県大), 鈴木 丈慈 (愛県大), 黒古 歩希 (愛県大), 大橋 玲音 (愛県大), 坪倉 和哉 (愛県大), 小林 邦和 (愛県大)

  • [S2-P42] 多人数対話の談話構造解析:LLM を用いた依存構造・対話行為の判定
    高田 尚輝 (横国大), 大勝 友洋 (横国大), 森 辰則 (横国大)

  • [S2-P50] ギャルは口調だけで成らず:当事者インタビューに基づく対話AIペルソナの設計と実装 【デモあり】
    池上 桃花 (駒大/産総研), 栗林 雅希 (早大), 加藤 卓哉 (駒大), 大西 正輝 (産総研), 平井 辰典 (駒大)

[17:05-18:05] ポスターセッション (3)

  • [S3-P28] 日本語対話環境におけるECエージェントの信頼性評価ベンチマーク
    二宮 大空 (CyberAgent)

  • [S3-P43] LLMによるインタビューにおける深堀り質問展開戦略の比較・評価
    土田 陸斗 (筑波大学), 園田 哲也 (筑波大学), 宇津呂 武仁 (筑波大学)

  • [S3-P44] DuplexChat:音声対話言語モデルのための大規模全二重音声対話コーパス
    中田 亘 (東大/産総研), 齋藤 佑樹 (東大/産総研), 猿渡 洋 (東大)

  • [S3-P45] 出来事に基づく認知症介護者の自然文感情予測におけるLLMの比較評価
    白川 桃子 (武蔵野大工), 佐々木 多希子 (武蔵野大工)

  • [S3-P49] 性格付けされた対話システムを実現するための適応的ステアリングによる大規模言語モデルの応答制御
    山上 藍稀 (JAIST)

8/18 (火): シンポジウム3日目

[10:40-11:40] ポスターセッション (4)

  • [S4-P13] 4者の会話における会話特性の分析
    清水 周一郎 (慶應大), 高道 慎之介 (慶應大/東大)

  • [S4-P40] コモングラウンドを用いた対話的協働におけるすれ違いの可視化と修復
    嶌根 伸一 (科学大), 吉野 幸一郎 (科学大/阪大), 荒瀬 由紀 (科学大), 佐藤 拓真 (奈良先端大)

  • [S4-P41] 対話における登場人物の感情の理解と活用に向けて
    小山 将生 (愛媛大), 近藤 里咲 (愛媛大), 高山 隼矢 (愛媛大), 梶原 智之 (愛媛大/阪大)

  • [S4-P42] 発話と応答の感情を独立に考慮した共感自由対話システムの構築
    山本 聖留 (JAIST), 白井 清昭 (JAIST)

  • [S4-P43] タスク指向対話におけるLLMエージェントの「気遣い」の能力を測るベンチマークの構築
    勝見 久央 (NTT/阪大), 吉野 幸一郎 (阪大), 水上 雅博 (NTT), 西田 京介 (NTT)

[13:20-14:20] ポスターセッション (5)

  • [S5-P12] Full-duplex音声対話システムの雑音頑健性評価
    中野 隼輔 (東大), 中田 亘 (東大), 齋藤 佑樹 (東大), 猿渡 洋 (東大)

  • [S5-P41] キャラクター発話文埋め込みの意味とスタイルの分離に向けて
    近藤 里咲 (愛媛大), 梶原 智之 (愛媛大/阪大)

  • [S5-P43] 個人差を考慮した対話ドメインにおける話者の主観的評価の推定
    三浦 拓人 (JAIST), 白井 清昭 (JAIST)

  • [S5-P46] 学習済みモデルを用いたAI人狼ゲームの発言タイミングの評価 【デモあり】
    加藤 もも香 (愛県大), 鈴木 丈慈 (愛県大), 大橋 玲音 (愛県大), 坪倉 和哉 (愛県大), 小林 邦和 (愛県大)

  • [S5-P47] 待つか、聞き返すか:日本語日常会話における修復開始タイミングのモデル化
    行旨 王我 (京都工繊大), 延原 章平 (京都工繊大), 河野 誠也 (京都工繊大)

(C5) 質問応答 Q&A / 8件

8/17 (月): シンポジウム2日目

[11:45-12:45] ポスターセッション (1)

  • [S1-P02] マルチホップ推論の内容と遷移に基づくグラフ構造を用いた自動分析
    大崎 稜司 (豊田工大), 三輪 誠 (豊田工大)

  • [S1-P43] Predicting Learner Response Distributions for Multiple-Choice Reading Questions
    Bian Kexin (一橋大), 小町 守 (一橋大)

[14:25-15:25] ポスターセッション (2)

  • [S2-P20] RAG出力に対するユーザー事実確認支援のためのタイプ別フレーズ根拠提示
    松本 悠太 (VAIABLE), Zhang Zizheng (マネーフォワード), 貞光 九月 (VAIABLE/マネーフォワード)

[17:05-18:05] ポスターセッション (3)

  • [S3-P26] LLMの誤謬検知は不当な説得による判断変化を防ぐのか:誤謬検知の内部表現とベクトル介入
    上原 慧大 (横浜国大), 村山 太一 (横浜国大)

8/18 (火): シンポジウム3日目

[13:20-14:20] ポスターセッション (5)

  • [S5-P02] 元データの評価観点を保持した制御可能なQAデータ拡張
    小島 亮 (豊田工大), 三輪 誠 (豊田工大)

  • [S5-P17] 農業文書中の栽培暦を対象とした補助線描画による視覚質問応答の改善の試み
    中川 菫 (小樽商大), 木村 泰知 (小樽商大)

  • [S5-P18] 文書VQAにおける画像拡大ツールを用いた推論の性能・コスト分析
    楢木 悠士 (シェルパ), 赤部 晃一 (シェルパ), 中山 功太 (NII-LLMC), 小田 悠介 (シェルパ/NII-LLMC)

  • [S5-P25] 税理士試験とフロンティアモデル
    小野 克樹 (VAIABLE), 佐原 恭平 (VAIABLE/京大), 貞光 九月 (VAIABLE)

(C6) 実世界接地と言語処理 Real-World Grounding and Language Processing / 14件

8/17 (月): シンポジウム2日目

[11:45-12:45] ポスターセッション (1)

  • [S1-P08] 複数の文章を読んで文書集合全体を把握して初めて回答できるベンチマーク
    出合 優実 (NAIST), 氷見 和 (NAIST), 柴田 大作 (NEC), 辻川 剛範 (NEC), 清水 聖司 (NAIST), 西山 智弘 (NAIST), 若宮 翔子 (NAIST), 荒牧 英治 (NAIST)

  • [S1-P19] VLMで軽量なフィジカルAIを作れるか?
    小林 稜佳 (日本女子大学), 土田 悠佳 (日本女子大学), 根本 さくら (日本女子大学), 西潟 優羽 (日本女子大学), 倉光 君郎 (日本女子大学)

  • [S1-P23] 小規模(ローカル)LLMは競技クイズを作れるか? 解答制約と外部検索によるハルシネーション抑制と評価の課題
    井上 智弘 (佐大)

  • [S1-P36] 議会会議録を対象とした適応的バッチSelf-Consistencyによる話者の役割分類
    蛇谷 祐人 (小樽商大), 木村 泰知 (小樽商大)

  • [S1-P37] 親契約書検索のための候補選択とリランキング
    大田尾 匠 (Sansan), 橋本 航 (Sansan)

  • [S1-P42] Do Clarification Questions Help? A Real-World Case Study on Underspecified Customer-Support QA
    Zhang Zizheng (マネーフォワード), 貞光 九月 (マネーフォワード)

[14:25-15:25] ポスターセッション (2)

  • [S2-P05] 言葉を介した観測と物理モデルを統合した人流推定
    佐久間 大地 (慶應), 井上 正樹 (慶應)

  • [S2-P16] VLAを用いたUAVナビゲーションのための未来予測と過去検証に基づく推論時スケーリング
    大井 聖也 (Science Tokyo), 宮西 大樹 (東大), 岡崎 直観 (Science Tokyo/産総研/NII LLMC)

  • [S2-P17] 長尺動画生成タスクにおけるプロンプトと動画間のシーン対応を考慮した自動評価
    吉田 遥音 (東北大), 工藤 慧音 (東北大), 松田 陵佑 (東北大), 清水 伸幸 (LINEヤフー), 鈴木 潤 (東北大)

8/18 (火): シンポジウム3日目

[10:40-11:40] ポスターセッション (4)

  • [S4-P12] 言語特異的ニューロンの抑制による学習フリーなクロスリンガル音声合成の品質改善
    増子 凱斗 (エクサウィザーズ), 和田 和浩 (エクサウィザーズ), 櫻井 大雅 (エクサウィザーズ)

  • [S4-P18] 視覚言語モデルと病徴属性を用いた植物病害診断手法の検討
    須藤 水基 (法政大), 畔上 達希 (法政大), 川田 拓朗 (法政大), 彌冨 仁 (法政大/法政大)

  • [S4-P45] AIエージェントが生成するアイデア系統樹の構造分析
    野首 優斗 (研究開発部)

[13:20-14:20] ポスターセッション (5)

  • [S5-P37] 不均一な公開LoRAプールにおける学習なしルーティング
    和田 和浩 (エクサウィザーズ)

  • [S5-P48] 麻雀AIの生成解説における盤面事実への忠実性と多事実列挙の限界分析 【デモあり】
    土田 蒼大 (N高/LLMATCH), 小橋 洋平 (LLMATCH/東京大学大学院工学系研究科)

(C7) 教育応用 Educational Applications / 10件

8/17 (月): シンポジウム2日目

[11:45-12:45] ポスターセッション (1)

  • [S1-P43] Predicting Learner Response Distributions for Multiple-Choice Reading Questions
    Bian Kexin (一橋大), 小町 守 (一橋大)

  • [S1-P44] 小学校漢字学習におけるLLM生成物語の「違和感」の類型化とLLM間の比較
    吉村 賢人 (大教大), 高見 享佑 (大教大), 古橋 萌々香 (東北大/NII LLMC), 中山 功太 (NII LLMC), 児玉 貴志 (NII LLMC)

[14:25-15:25] ポスターセッション (2)

  • [S2-P10] 難易度制御のための適応的事例選択に基づく検索拡張生成
    宮田 莉奈 (愛媛大), 梶原 智之 (愛媛大/阪大)

  • [S2-P43] 数学におけるサブスキルプロファイルに基づく学習者シミュレーションの検討
    渡邊 裕介 (東北大), 松林 優一郎 (東北大/理研), 畔柳 直旺 (東北大/理研), 坂口 慶祐 (東北大/理研)

  • [S2-P48] 北海道アイヌ語に対する音声合成モデルの学習と評価 【デモあり】
    花田 佳文 (東大), 中田 琉稀 (東大), 林 克彦 (東大)

[17:05-18:05] ポスターセッション (3)

  • [S3-P50] LLMを用いた授業映像の翻訳 【デモあり】
    内田 和史 (筑波大), 山元 大地 (筑波大), 梶田 楓斗 (筑波大), 西村 信頼 (筑波大), 武藤 直輝 (山梨大), 宇津呂 武仁 (筑波大), レオ チーシャン (山梨大), 西崎 博光 (山梨大)

8/18 (火): シンポジウム3日目

[10:40-11:40] ポスターセッション (4)

  • [S4-P04] 大規模言語モデルによる数学解説生成のための学習データセットの構築
    高須 弘政 (愛工大), 鳥巣 裕斗 (愛工大/NII LLMC), 徳久 良子 (愛工大/理研)

  • [S4-P44] Toward a Japanese Office-Task Agent Benchmark: A Preliminary Localization of OdysseyBench
    Su Myat Noe (特任研究員, 国立情報学研究所 大規模言語モデル研究開発センター), 功太 中山 (特任研究員, 国立情報学研究所 大規模言語モデル研究開発センター), Yunang Wu (特任研究員, 国立情報学研究所 大規模言語モデル研究開発センター)

[13:20-14:20] ポスターセッション (5)

  • [S5-P08] 大規模言語モデルの埋め込みノルムに基づく連続的な文難易度制御に向けて
    野々村 奏 (愛媛大), 梶原 智之 (愛媛大/阪大), 荒瀬 由紀 (科学大)

  • [S5-P49] 画像を活用した英文ライティング支援システムの提案 【デモあり】
    宇野 和志 (愛工大), 永田 亮 (甲南大), 徳久 良子 (愛工大/理研)

(C8) その他の応用 Other Applications / 25件

8/17 (月): シンポジウム2日目

[11:45-12:45] ポスターセッション (1)

  • [S1-P13] 言語想起時の言語中枢間の位相同期に着目した単語認識
    小島 咲良 (愛県大), 長瀬 南帆 (愛県大), 坪倉 和哉 (愛県大), 入部 百合絵 (愛県大)

  • [S1-P35] 追加学習前後の重み差分を用いた言語モデルの学習ドメイン理解に関する自己評価
    小野 聡 (早大)

  • [S1-P38] 選挙情報空間におけるクリックベイト的表現の効果:2025年参院選YouTube動画の傾向スコアマッチング分析
    中村 響 (東大), 伊藤 和浩 (東大), 太田 光紀 (東大), 鳥海 不二夫 (東大)

  • [S1-P45] 意外性と実現可能性を両立する異分野転用アイデア創出のための自律的探索エージェント
    進藤 尚希 (ストックマーク/電通大), 広田 航 (ストックマーク), 高橋 洸丞 (ストックマーク), 有馬 幸介 (ストックマーク)

  • [S1-P46] テキストの意味的ソート・順序制約付き意味的ソート 【デモあり】
    福地 成彦 (SB Intuitions)

[14:25-15:25] ポスターセッション (2)

  • [S2-P06] 法律相談テキストデータセットにおける判例エンティティリンキング
    南 理久 (豊橋技科大), 土屋 雅稔 (豊橋技科大)

  • [S2-P18] フォントはVLMの日本語テキスト画像理解に影響するのか?
    戸田 裕子 (愛媛大), 米山 瑛人 (愛媛大), 梶原 智之 (愛媛大/阪大)

  • [S2-P43] 数学におけるサブスキルプロファイルに基づく学習者シミュレーションの検討
    渡邊 裕介 (東北大), 松林 優一郎 (東北大/理研), 畔柳 直旺 (東北大/理研), 坂口 慶祐 (東北大/理研)

  • [S2-P44] 数値指示によるゲームLLMエージェントの強さとプレイスタイルの制御
    坂本 充生 (サイバーエージェント), 阿部 拳之 (サイバーエージェント), 陣内 佑 (サイバーエージェント), 蟻生 開人 (サイバーエージェント)

  • [S2-P45] 汎用マルチモーダルLLMによるAI生成・改変画像の検知
    吉水 優里子 (NHK), 川瀬 恵 (NHK), 小西 修平 (NHK), 紺野 瑛介 (NHK), 月山 凛帆子 (NHK), 松本 英資 (NHK)

[17:05-18:05] ポスターセッション (3)

  • [S3-P02] 医療事故報告書の事故事象・背景要因・改善策と抽象化項目を結び付けたデータセットの構築
    長谷山 優菜 (北大), 伊藤 友貴 (NICT), 坂地 泰紀 (北大), 野田 五十樹 (北大)

  • [S3-P03] 進歩性判定のための主引用・副引用構造を反映した特許拒絶理由データセットの構築
    白鳥 華枝 (一橋大), 山本 直生 (一橋大), 山田 寛章 (都立大), 河野 誠也 (京都工芸繊維大), 相澤 彰子 (NII), 欅 惇志 (一橋大)

  • [S3-P20] LLMによる経費精算ルールの自動適応
    王 悦綸 (マネーフォワード), 山岸 駿秀 (マネーフォワード), 貞光 九月 (マネーフォワード)

  • [S3-P41] 大規模言語モデルによる決算短信の評価と株価への情報織り込み分析
    河本 道弥 (JPSI), 多田 大 (JPSI), 源 怜維 (JPSI)

  • [S3-P46] Webエージェントのタスク遂行を阻害するWebサイト特性の帰納的分析
    山﨑 善啓 (NTT), 北条 伸克 (NTT), 鈴木 啓太 (NTT), 小篭 蒼 (NTT), 三浦 大和 (NTT), 西田 京介 (NTT)

8/18 (火): シンポジウム3日目

[10:40-11:40] ポスターセッション (4)

  • [S4-P10] Tanka Diffusion ―拡散モデルによる短歌の自動生成―
    羽根田 賢和 (東北大), 坂口 慶祐 (東北大/理研)

  • [S4-P14] Code2Figure: 学術論文における実装コードに基づくモデル図生成の初期検討
    川田 拓朗 (法政大/ZOZO研究所), 守田 竜梧 (RPTU & DFKI), 清水 良太郎 (ZOZO研究所), 渡邉 洸 (RPTU & DFKI), 彌冨 仁 (法政大)

  • [S4-P20] LLMへのESG開示関連情報の付与はESGレポートのコンプライアンスチェックに役立つか?
    解良 智紀 (一橋大), 関 洋平 (筑波大), 中尾 悠利子 (関大), 高村 大也 (産総研), 欅 惇志 (一橋大)

  • [S4-P28] 日本の有権者ペルソナからLLMが生成する友人ネットワークの検証
    高柳 慶太郎 (京大), 廣中 詩織 (京大), 首藤 一幸 (京大)

  • [S4-P45] AIエージェントが生成するアイデア系統樹の構造分析
    野首 優斗 (研究開発部)

  • [S4-P46] LLMによるペルソナ駆動型移動シミュレーション:多様な身体・心理的制約下での意思決定のための満足度評価
    遠藤 純音 (奈良先端大), 久田 祥平 (奈良先端大), 荒牧 英治 (奈良先端大), 若宮 翔子 (奈良先端大)

  • [S4-P48] 牛舎内音声を用いた教師なし異常検知手法の検討 【デモあり】
    寺尾 瑠真 (愛県大), 坪倉 和哉 (愛県大), 神谷 咲月 (農総試), 小島 秀介 (農総試), 兒嶋 朋貴 (農研機構), 入部 百合絵 (愛県大)

  • [S4-P50] 誤情報拡散防止のためのコミュニティノート作成理由生成タスクの提案 【デモあり】
    田口 雄大 (筑波大学), 山本 勇太 (筑波大学), 嶋津 瑛 (筑波大学), 王 婧薇 (筑波大学), 宇津呂 武仁 (筑波大学)

[13:20-14:20] ポスターセッション (5)

  • [S5-P38] 医療ドメイン文書からの教師なし時間関係グラフ生成
    田村 聡信 (科学大), 荒瀬 由紀 (科学大)

  • [S5-P44] 自動運転制御のためのAIエージェント
    宮岡 佑弥 (慶大), 井上 正樹 (慶大)
第21回言語処理若手シンポジウム(YANS2026) プログラム

更新履歴

  • プログラム詳細を公開しました(2026/07/31) new!
  • プログラム概要を公開しました(2026/06/19)

シンポジウム1日目: 8/16 (日) 仙台国際センター 展示室3

[13:00-13:30] 受付 (ハッカソン)

[13:30-19:30] ハッカソン

  • 昨年に引き続きシンポジウム1日目の 8月16日(日)に分野交流ハッカソンを行います。自然言語処理の周辺分野(画像・音声処理など)をはじめ、人文・社会学分野も含めた幅広い分野の学生・社会人の交流を促進することが目的のひとつです。
    第21回言語処理若手シンポジウム(YANS2026) 分野交流ハッカソン

シンポジウム2日目: 8/17 (月) 仙台国際センター 展示室1・2

[09:30-10:00] 受付

[10:00-10:30] オープニング

[10:30-11:30] チュートリアル(1) 「現場から世界標準へ:QRコード開発に学ぶ『読める』の設計原理」

講演者: 長屋 隆之 氏 (株式会社 豊田中央研究所 ヒューマンサイエンス研究領域)
概要: QRコードは、現場の要求を起点に、認識(検出・補正)と符号化(誤り訂正)の統合設計によって世界中で使われる標準技術となりました。本講演では、開発者の視点から要点を振り返り、自然言語処理や画像・音声処理など多様な分野でも参考になり得る設計判断の観点を紹介します。まず、なぜQRコードが必要とされたのか、どのような制約(読み取り時間、低誤読率、印刷・撮像条件など)が設計を方向づけたのかを説明します。続いて、位置検出、幾何補正、タイミングパターン、フォーマット情報などのアーキテクチャを図解し、実環境下で高速読み取りを成立させる工夫を解説します。さらに、二次元バースト誤りという失敗パターン(失敗モード)を想定した誤り訂正(Reed-Solomon符号、配置、訂正レベル)を取り上げ、評価指標と失敗パターンの見立てが設計を支えた点を整理します。最後に、設計を駆動する「制約・評価・失敗パターン」の関係をまとめます。
略歴: 株式会社豊田中央研究所 主監・リーディングリサーチャー。1991年名古屋大学大学院修士課程修了。豊田中央研究所に入社後、エキスパートシステムの開発を経てQRコードの開発に着手、主に誤り訂正機能の実装・評価やコードの符号化・復号プログラムの実装を担当。近年はデータ解析やWebアプリ、スマホアプリ試作も手掛け、現在はウェアラブルデバイスを活用した人の状態推定やWell-beingなどの研究に従事。

[11:45-12:45] ポスターセッション (1)

  • [S1-P01] AIエージェントのためのツール呼び出し評価データJMultiWOZ-TCの構築
    清水 綾太 (愛工大/NII LLMC), 中山 功太 (NII LLMC), 守山 慧 (東大/NII LLMC), 徳久 良子 (愛工大/理研), 宮尾 雄介 (東大/NII LLMC)

  • [S1-P02] マルチホップ推論の内容と遷移に基づくグラフ構造を用いた自動分析
    大崎 稜司 (豊田工大), 三輪 誠 (豊田工大)

  • [S1-P03] 典拠に基づいた事実性判定テストセットの構築
    田口 凜采 (豊橋技科大), 土屋 雅稔 (豊橋技科大/NICT)

  • [S1-P04] 大規模NERデータセット構築に向けた単語置換によるデータ拡張
    前川 大輔 (愛媛大), 藤井 諒 (フューチャー), 森下 睦 (フューチャー), 梶原 智之 (愛媛大/阪大)

  • [S1-P05] オンライン記事の引用に伴う解釈変化を捉えるデータセット構築
    後藤 隆希 (横浜国大), 吉田 光男 (筑波大), 村山 太一 (横浜国大)

  • [S1-P06] 生活者解釈と実務的規範解釈を中間表現とする広告法務審査の潜在変数モデル化に向けた検討
    石垣 龍馬 (HT), 森川 祐介 (HT)

  • [S1-P07] 生成AIはプランニングできるのか? ― 暗黙知を含む料理タスクのシングル/マルチタスク生成 ―
    十津 梨治句 (愛工大), 徳久 良子 (愛工大/理研)

  • [S1-P08] 複数の文章を読んで文書集合全体を把握して初めて回答できるベンチマーク
    出合 優実 (NAIST), 氷見 和 (NAIST), 柴田 大作 (NEC), 辻川 剛範 (NEC), 清水 聖司 (NAIST), 西山 智弘 (NAIST), 若宮 翔子 (NAIST), 荒牧 英治 (NAIST)

  • [S1-P09] End-to-Endモデルに基づく係り受け解析と語順整序の同時実行
    箭内 太郎 (東京電機大), 大野 誠寛 (東京電機大)

  • [S1-P10] 「今一度」より「今井ちど」? 意図的な誤字プロンプトによるTTSの調整
    千頭和 翔悟 (IVRy/慶応大), 吉田 快 (IVRy), 町田 雄一郎 (IVRy)

  • [S1-P11] 認知症カフェの対話音声を用いた音声感情認識に向けたデータ構築と分析
    山川 祥 (武蔵野大工), 佐々木 多希子 (武蔵野大工)

  • [S1-P12] 自動音声認識器を用いたアクセント位置検出
    三上 万里菜 (東京理科大), 松崎 拓也 (東京理科大)

  • [S1-P13] 言語想起時の言語中枢間の位相同期に着目した単語認識
    小島 咲良 (愛県大), 長瀬 南帆 (愛県大), 坪倉 和哉 (愛県大), 入部 百合絵 (愛県大)

  • [S1-P14] LLMは未知言語のコードを何語で考えているか
    森部 七海 (本女), 西潟 優羽 (本女), 宮田 侑佳 (本女), 倉光 君郎 (本女)

  • [S1-P15] VLMは複雑な表画像をどこまで読めるか? ― 行数・列数・セル結合を制御した表構造認識の性能分析 ―
    會田 勇斗 (ストックマーク), 陳 実 (ストックマーク), 森長 誠 (ストックマーク), 田中 翔平 (ストックマーク), 有馬 幸介 (ストックマーク)

  • [S1-P16] CLIPにおける埋め込みのノルムは本当に捨ててよいのか?
    佐藤 祥太 (一橋), 木山 朔 (一橋), 平澤 寅庄 (一橋), 小町 守 (一橋)

  • [S1-P17] 観光キャッチコピー自動生成に向けた学習用データセットの構築
    鳥巣 裕斗 (愛工大/NII LLMC), 徳久 良子 (愛工大/理研)

  • [S1-P18] 図表解像度に着目したVLMのハルシネーション傾向の分析
    根本 さくら (日本女子大学), 土田 悠佳 (日本女子大学大学院), 宮田 侑佳 (日本女子大学大学院), 倉光 君郎 (日本女子大学)

  • [S1-P19] VLMで軽量なフィジカルAIを作れるか?
    小林 稜佳 (日本女子大学), 土田 悠佳 (日本女子大学), 根本 さくら (日本女子大学), 西潟 優羽 (日本女子大学), 倉光 君郎 (日本女子大学)

  • [S1-P20] LLMが自動構築した知識グラフの構築品質と検索有効性の分析
    水野 多加雄 (FRAIM), 狩野 芳伸 (静大)

  • [S1-P21] 実テキストを参照した多様なLLMデータ拡張
    平松 優弥 (豊田工大), 井田 龍希 (豊田工大), 三輪 誠 (豊田工大)

  • [S1-P22] 長期タスクにおけるLLMエージェントの自律的文脈管理能力の学習
    Kumdee Thanasan (Science Tokyo), 馬 尤咪 (Science Tokyo), 岡崎 直観 (Science Tokyo/産総研/NII LLMC)

  • [S1-P23] 小規模(ローカル)LLMは競技クイズを作れるか? 解答制約と外部検索によるハルシネーション抑制と評価の課題
    井上 智弘 (佐大)

  • [S1-P24] 異なる語彙を持つ LLM 間のオンポリシ蒸留
    木村 優介 (JST/名大/同大), 駒水 孝裕 (名大), 波多野 賢治 (同大), 石川 佳治 (名大)

  • [S1-P25] 汎用テキスト評価モデル構築に向けた評価観点の自律的選択能力の検証
    田中 杏 (お茶大), 小林 一郎 (お茶大)

  • [S1-P26] オチ(punchline)あるいはtwist ending型物語を対象としたLLMによる結末理解の説明タスク
    程 嘉実 (筑波大), 宇津呂 武仁 (筑波大)

  • [S1-P27] 日本語文章の道徳的判断における人間とLLMの情報要求量の差異分析
    伊藤 達也 (法政), 大橋 巧 (法政), 彌冨 仁 (法政)

  • [S1-P28] 入力テキストとのアライメントを提供するハルシネーションスパン検出手法
    山田 美優 (科学大), 荒瀬 由紀 (科学大)

  • [S1-P29] 子どもにとって安全なLLMとは?〜想定応答に対する人手評価とLLM-as-a-judgeの比較分析〜
    野村 瑛吉 (横国大), 杉山 弘晃 (AISI), 黒田 麻衣子 (山陽学園大), 清水 良太郎 (早大), 高橋 史 (信州大), 高見 享佑 (大教大), 安藤 祐介 (みんなのコード), 中山 功太 (NII LLMC), 森 辰則 (横国大)

  • [S1-P30] 一様拡散言語モデルの能力獲得過程
    佐々木 睦史 (東北大), 葉 夢宇 (東北大), 趙 羽風 (理研), 工藤 慧音 (東北大/理研), 坂口 慶祐 (東北大/理研), 鈴木 潤 (東北大/理研/NII LLMC)

  • [S1-P31] Perplexityによるカットオフ推定値は何を反映しているか ― 学習データからの検証
    山下 果凜 (日本女子大), 西潟 優羽 (日本女子大), 倉光 君郎 (日本女子大)

  • [S1-P32] タスクベクトルは説明可能かつ制御可能な成分に線型分解できる
    堀場 幸也 (慶大), 趙 羽風 (理研/東北大), 矢向 高弘 (慶大)

  • [S1-P33] LLM最終隠れ層での急激な変化の要因と影響
    柴田 圭悟 (東北大), 小林 颯介 (東北大), 高瀬 翔 (東北大), 矢野 一樹 (東北大), リュウ センペイ (SB Intuitions), 鈴木 潤 (東北大)

  • [S1-P34] LLMは感情強度の高いエピソードを優先して記憶するのか — 獲得・保持と想起前後の内部表現
    大西 直 (JAIST/松尾研究所), 北島 祥平 (JAIST), 手塚 陽大 (JAIST), 井之上 直也 (JAIST)

  • [S1-P35] 追加学習前後の重み差分を用いた言語モデルの学習ドメイン理解に関する自己評価
    小野 聡 (早大)

  • [S1-P36] 議会会議録を対象とした適応的バッチSelf-Consistencyによる話者の役割分類
    蛇谷 祐人 (小樽商大), 木村 泰知 (小樽商大)

  • [S1-P37] 親契約書検索のための候補選択とリランキング
    大田尾 匠 (Sansan), 橋本 航 (Sansan)

  • [S1-P38] 選挙情報空間におけるクリックベイト的表現の効果:2025年参院選YouTube動画の傾向スコアマッチング分析
    中村 響 (東大), 伊藤 和浩 (東大), 太田 光紀 (東大), 鳥海 不二夫 (東大)

  • [S1-P39] J-RhymeDetector: 日本語ラップにおける押韻スパン検出モデルの構築
    小川 隼斗 (早大), 河原 大輔 (早大)

  • [S1-P40] 笑い声先読みに基づくプロアクティブ対話システム
    内山 大希 (科学大)

  • [S1-P41] LLMの長期記憶における記憶手法の情報損失分析
    坂本 拓優 (電大)

  • [S1-P42] Do Clarification Questions Help? A Real-World Case Study on Underspecified Customer-Support QA
    Zhang Zizheng (マネーフォワード), 貞光 九月 (マネーフォワード)

  • [S1-P43] Predicting Learner Response Distributions for Multiple-Choice Reading Questions
    Bian Kexin (一橋大), 小町 守 (一橋大)

  • [S1-P44] 小学校漢字学習におけるLLM生成物語の「違和感」の類型化とLLM間の比較
    吉村 賢人 (大教大), 高見 享佑 (大教大), 古橋 萌々香 (東北大/NII LLMC), 中山 功太 (NII LLMC), 児玉 貴志 (NII LLMC)

  • [S1-P45] 意外性と実現可能性を両立する異分野転用アイデア創出のための自律的探索エージェント
    進藤 尚希 (ストックマーク/電通大), 広田 航 (ストックマーク), 高橋 洸丞 (ストックマーク), 有馬 幸介 (ストックマーク)

  • [S1-P46] テキストの意味的ソート・順序制約付き意味的ソート 【デモあり】
    福地 成彦 (SB Intuitions)

  • [S1-P47] 誤情報拡散防止を目的としたXポストへのコミュニティノート付与手法の提案 【デモあり】
    嶋津 瑛 (筑波大), 田口 雄大 (筑波大), 山本 勇太 (筑波大), 王 婧薇 (筑波大), 宇津呂 武仁 (筑波大)

  • [S1-P48] 形態素トークナイザーの効果検証に向けた日本語エンティティ追跡ベンチマークの構築 【デモあり】
    舘 健太朗 (愛県大), 坪倉 和哉 (愛県大), 入部 百合絵 (愛県大)

  • [S1-P49] 特許請求項翻訳評価のためのルーブリックに基づくLLM-as-a-Judgeの提案 【デモあり】
    FU YINGYI (筑波大), 宇津呂 武仁 (筑波大), 永田 昌明 (CS研)

  • [S1-P50] 運転負荷に合わせた音声対話システム 【デモあり】
    新垣 嘉成太 (愛工大), 徳久 良子 (愛工大/理研)

[12:45-14:25] 昼休憩

([13:55-14:25] カジュアル交流会 ※希望者のみ)

[14:25-15:25] ポスターセッション (2)

  • [S2-P01] 日本語エージェントベンチマーク「J-tau」の構築
    矢野 千紘 (SB Intuitions/名大), 平子 潤 (SB Intuitions), 廣淵 亮太 (SB Intuitions)

  • [S2-P02] 「待つ」は一瞬か数時間か:LLMによるイベント持続時間の評価
    松﨑 孝介 (東北大), 谷口 雅弥 (理研)

  • [S2-P03] 日本語マルチモーダル埋め込みベンチマーク構築の検討
    李 聖哲 (SB Intuitions), 小川 隼斗 (SB Intuitions)

  • [S2-P04] 校正・校閲データセット構築に向けた記事編集者の指摘情報に対する誤り分類
    岩本 和真 (日経), 白井 穂乃 (日経)

  • [S2-P05] 言葉を介した観測と物理モデルを統合した人流推定
    佐久間 大地 (慶應), 井上 正樹 (慶應)

  • [S2-P06] 法律相談テキストデータセットにおける判例エンティティリンキング
    南 理久 (豊橋技科大), 土屋 雅稔 (豊橋技科大)

  • [S2-P07] 口語オランダ語・フラマン語において動詞クラスター内語順を決定する要因の最大エントロピーモデルでの分析
    田中 醇之介 (東大), 林 克彦 (東大)

  • [S2-P08] 現代日本語短歌における脳内感情処理機構の解明へ向けて
    黒川 真琳 (お茶大), 持橋 大地 (統数研/国語研), 小林 一郎 (お茶大)

  • [S2-P09] 語彙制約を用いた生成モデルによる仮名漢字変換
    土手 陸渡 (東京電機大), 大野 誠寛 (東京電機大)

  • [S2-P10] 難易度制御のための適応的事例選択に基づく検索拡張生成
    宮田 莉奈 (愛媛大), 梶原 智之 (愛媛大/阪大)

  • [S2-P11] 生成過程の段階的分解によるフロー言語モデルの品質改善
    大塚 雄貴 (科学大), 大葉 大輔 (科学大), 岡崎 直観 (科学大/産総研/NII LLMC)

  • [S2-P12] 質問駆動型の情報抽出による将棋AI指し手の対話的解説生成
    大原 蒼生 (理科大)

  • [S2-P13] 音声対話システムにおける未知語獲得のための音節認識確信度を用いた不要な聞き返し抑制
    古田 拓己 (産研), 武田 龍 (産研), 駒谷 和範 (産研)

  • [S2-P14] 複数のスポーツ競技映像と実況テキスト対が視覚言語モデルの性能に与える影響
    島野 雄貴 (NHK), 熊野 正 (NHK)

  • [S2-P15] 再帰的Transformerはデータ制約下で何に効いて何に効かないのか
    堀田 大智 (青学), 小橋 洋平 (東大), 小島 武 (東大), 岩澤 有祐 (東大), 松尾 豊 (東大)

  • [S2-P16] VLAを用いたUAVナビゲーションのための未来予測と過去検証に基づく推論時スケーリング
    大井 聖也 (Science Tokyo), 宮西 大樹 (東大), 岡崎 直観 (Science Tokyo/産総研/NII LLMC)

  • [S2-P17] 長尺動画生成タスクにおけるプロンプトと動画間のシーン対応を考慮した自動評価
    吉田 遥音 (東北大), 工藤 慧音 (東北大), 松田 陵佑 (東北大), 清水 伸幸 (LINEヤフー), 鈴木 潤 (東北大)

  • [S2-P18] フォントはVLMの日本語テキスト画像理解に影響するのか?
    戸田 裕子 (愛媛大), 米山 瑛人 (愛媛大), 梶原 智之 (愛媛大/阪大)

  • [S2-P19] 文書レイアウト解析モデルのEnd-to-End学習における損失関数切り替えの効果
    浅野 翔祐 (シェルパ), 赤部 晃一 (シェルパ), 小田 悠介 (シェルパ/NII-LLMC)

  • [S2-P20] RAG出力に対するユーザー事実確認支援のためのタイプ別フレーズ根拠提示
    松本 悠太 (VAIABLE), Zhang Zizheng (マネーフォワード), 貞光 九月 (VAIABLE/マネーフォワード)

  • [S2-P21] 自己進化型強化学習における良いサンプルとは何か?
    宮本 空 (科学大), 大葉 大輔 (科学大), 小池 隆斗 (科学大), 大井 聖也 (科学大), 岡崎 直観 (科学大/産総研/NIILLMC)

  • [S2-P22] 自動分析エージェントの構築に向けた思考経路の拡張に基づくLLMの思考言語の制御
    三橋 亮太 (サイバーエージェント)

  • [S2-P23] JFBench: 実務レベルの日本語指示追従性能を備えた生成AIを目指して
    今村 秀明 (PFN)

  • [S2-P24] LLM-as-a-Judgeにおけるリッカート評価とランキング評価の比較分析
    松田 翔汰 (東北大), 柴田 圭悟 (東北大), 津田 純花 (東北大), 有川 透矢 (東北大), クェク ヨン シン (東北大), 池田 航 (東北大), 齋藤 由佳 (東北大), 種口 暁人 (東北大), 松田 陵佑 (東北大), 赤間 怜奈 (東北大/理研/国語研), 鈴木 潤 (東北大/理研/NII LLMC)

  • [S2-P25] 自己生成少数例の事前選択による LLM 安全性忘却の防止
    森田 知颯 (東大), 鶴岡 慶雅 (東大)

  • [S2-P26] 検証拡張生成: LLM 応答の真偽検証結果に基づく再生成
    政野 美和 (一橋大/NII LLMC), 欅 惇志 (一橋大), 欅 リベカ (東京工科大), 市岡 奨平 (一橋大/NII LLMC), 河原 大輔 (NII LLMC/早大)

  • [S2-P27] 言語モデルは文脈に依存する個人情報を検知できるのか
    西潟 優羽 (日本女子大), 山下 果凜 (日本女子大), 倉光 君郎 (日本女子大)

  • [S2-P28] ドロップアウト率は実モデル群の出力多様性を再現できるか
    剱持 壮吾 (理科大), 松崎 拓也 (理科大)

  • [S2-P29] LLMは専門知識を正しくコードに実装できるのか?
    間部 永理奈 (日本女子大)

  • [S2-P30] Activation Steeringにおける文章崩壊の抑制に向けた初期検討
    西山 天 (法政大), 川田 拓朗 (法政大), 北田 俊輔 (法政大), 永井 大地 (法政大), 彌冨 仁 (法政大)

  • [S2-P31] Beyond Recomputation: Direct Routing as a General Information-Reuse Strategy in LLMs
    李 睿 (JAIST), 趙 羽風 (理研/東北大), 井之上 直也 (JAIST/理研)

  • [S2-P32] VisEditBench: 視覚的指示を用いたダイアグラム編集ベンチマーク
    種口 暁人 (東北大), 斉藤 いつみ (東北大/科学大/理研), 吉田 遥音 (東北大), 鈴木 潤 (東北大/理研/NII LLMC)

  • [S2-P33] マルチホップQAにおけるLLMの中間概念想起の分析
    友成 光 (日立), 永塚 光一 (日立)

  • [S2-P34] SFTによって形成される内部表現の変化は、エンティティ中心学習とスキル中心学習でどう異なるか
    大田 眞滉 (愛工大), 徳久 良子 (愛工大/理研)

  • [S2-P35] 行動認識モデルの手話継続事前学習
    宇野 駿希 (豊田工大), 三輪 誠 (豊田工大)

  • [S2-P36] 大規模言語モデルと自己修正に基づく歌唱可能な歌詞への Phonemic Translation
    阪井 瞭介 (慶大), 深尾 貫太 (慶大), 高道 慎之介 (慶大/東大)

  • [S2-P37] 大規模言語モデルの商品推薦における説明文最適化の性能評価
    館林 裕太 (武蔵野大工)

  • [S2-P38] 大規模言語モデルによる個人特化感情分析の性能評価
    花房 健太郎 (愛媛大), 前川 大輔 (愛媛大), 梶原 智之 (愛媛大/阪大)

  • [S2-P39] 対話における話者本人の心情を第三者はどこまで推測できるか
    田中 義規 (電通大), 井上 昂治 (京大), 稲葉 通将 (電通大)

  • [S2-P40] 音声対話における発話タイミング予測
    大西 一誉 (奈良先端/理研/阪大), 大中 緋慧 (奈良先端/理研), 吉野 幸一郎 (奈良先端/理研/阪大/科学大)

  • [S2-P41] ワードウルフにおける対話戦略と単語推定過程の分析
    松垣 颯夏 (愛県大), 西尾 琉惺 (愛県大), 鈴木 丈慈 (愛県大), 黒古 歩希 (愛県大), 大橋 玲音 (愛県大), 坪倉 和哉 (愛県大), 小林 邦和 (愛県大)

  • [S2-P42] 多人数対話の談話構造解析:LLM を用いた依存構造・対話行為の判定
    高田 尚輝 (横国大), 大勝 友洋 (横国大), 森 辰則 (横国大)

  • [S2-P43] 数学におけるサブスキルプロファイルに基づく学習者シミュレーションの検討
    渡邊 裕介 (東北大), 松林 優一郎 (東北大/理研), 畔柳 直旺 (東北大/理研), 坂口 慶祐 (東北大/理研)

  • [S2-P44] 数値指示によるゲームLLMエージェントの強さとプレイスタイルの制御
    坂本 充生 (サイバーエージェント), 阿部 拳之 (サイバーエージェント), 陣内 佑 (サイバーエージェント), 蟻生 開人 (サイバーエージェント)

  • [S2-P45] 汎用マルチモーダルLLMによるAI生成・改変画像の検知
    吉水 優里子 (NHK), 川瀬 恵 (NHK), 小西 修平 (NHK), 紺野 瑛介 (NHK), 月山 凛帆子 (NHK), 松本 英資 (NHK)

  • [S2-P46] 抽象的な言葉からのWebサイトのデザイン自動生成 【デモあり】
    山本 葵 (愛工大), 徳久 良子 (愛工大/理研)

  • [S2-P47] 漸進的音声合成におけるSpeechLMからのフィードバックを用いたチャンク境界の最適化 【デモあり】
    小林 樹 (SCSK), Qin Xiuyuan (SCSK), 矢野 祐貴 (SCSK)

  • [S2-P48] 北海道アイヌ語に対する音声合成モデルの学習と評価 【デモあり】
    花田 佳文 (東大), 中田 琉稀 (東大), 林 克彦 (東大)

  • [S2-P49] 事後学習による相対評価性能の向上は、ユーモア理解能力の改善を意味するのか? 【デモあり】
    伊藤 大陽 (一橋大), 金 輝燦 (一橋大), 平澤 寅庄 (一橋大), 小町 守 (一橋大)

  • [S2-P50] ギャルは口調だけで成らず:当事者インタビューに基づく対話AIペルソナの設計と実装 【デモあり】
    池上 桃花 (駒大/産総研), 栗林 雅希 (早大), 加藤 卓哉 (駒大), 大西 正輝 (産総研), 平井 辰典 (駒大)

[15:40-16:50] スポンサーセッション

スポンサーの企業/団体における自然言語処理や関連分野の技術の活用事例などについてご紹介いただきます。

[17:05-18:05] ポスターセッション (3)

  • [S3-P01] Constructing a Multilingual Parallel Corpus from Fandom Wikis: A Pokemon Case Study
    宋 玄遇 (NAIST), 尾崎 慎太郎 (NAIST), 林 和樹 (NAIST), 上垣外 英剛 (NAIST), 林 克彦 (東大), 渡辺 太郎 (NAIST)

  • [S3-P02] 医療事故報告書の事故事象・背景要因・改善策と抽象化項目を結び付けたデータセットの構築
    長谷山 優菜 (北大), 伊藤 友貴 (NICT), 坂地 泰紀 (北大), 野田 五十樹 (北大)

  • [S3-P03] 進歩性判定のための主引用・副引用構造を反映した特許拒絶理由データセットの構築
    白鳥 華枝 (一橋大), 山本 直生 (一橋大), 山田 寛章 (都立大), 河野 誠也 (京都工芸繊維大), 相澤 彰子 (NII), 欅 惇志 (一橋大)

  • [S3-P04] 日本語MWE用法判断におけるアノテータ型LLMエージェントの比較分析
    大橋 美緒 (一橋), 小町 守 (一橋)

  • [S3-P05] 教育AIエージェントのための授業指導案データセット構築に向けて
    間瀬 なる美 (大教大)

  • [S3-P06] クロスモーダル意匠理解に向けた日本語意匠公報データセット構築とベンチマーク設計
    白田 連大 (京都工繊大), 野中 尋史 (愛工大), 延原 章平 (京都工繊大), 河野 誠也 (京都工繊大)

  • [S3-P07] Zipf則の頑健性――『残像に口紅を』を題材に
    中石 海 (理研/国語研)

  • [S3-P08] 複統合的言語 アイヌ語のサブワード分割 〜機械翻訳モデルに最適なトークナイザーとは〜
    中田 琉稀 (東大後期教養), 花田 佳文 (東大言語情報), 林 克彦 (東大言語情報)

  • [S3-P09] 階層的な質問による解釈可能なテキスト埋め込み
    小田 康平 (JAIST), 荘 博閔 (東芝)

  • [S3-P10] LLM-as-a-Judgeのフィードバックを用いた株価変動理由記事の繰り返し生成
    小齋 友里菜 (筑波大学), 土田 陸斗 (筑波大学), 謝 宇程 (筑波大学)

  • [S3-P11] 句を考慮したマスク拡散言語モデル
    山内 大暉 (豊田工大), 三輪 誠 (豊田工大)

  • [S3-P12] 前臨床期アルツハイマー病検出に向けた高齢者自由会話音声認識の検討
    種村 圭師 (愛県大), 坪倉 和哉 (愛県大), 入部 百合絵 (愛県大), 北岡 教英 (豊橋技科大)

  • [S3-P13] 長尺音声のための談話グラフ誘導型同時音声翻訳
    矢野 祐貴 (SCSK), Qin Xiuyuan (SCSK), 小林 樹 (SCSK)

  • [S3-P14] 文字と質問の対応関係を保証した日本語シーンテキストVQAデータの合成と学習に向けて
    前田 航希 (科学大/NII LLMC), 岡崎 直観 (科学大/NII LLMC)

  • [S3-P15] 日本語文書を対象としたマルチモーダルRAGにおけるモダリティの影響分析
    安川 浩貴 (ドコビジ)

  • [S3-P16] MECHA-ja を用いた人間とVLMの常識理解の差の分析に向けて
    濱本 惇之介 (愛媛大/NII LLMC), 中山 功太 (NII LLMC), 徳久 良子 (愛工大/理研), 二宮 崇 (愛媛大), 岡崎 直観 (NII LLMC/科学大/産総研)

  • [S3-P17] VLMはかわいいを理解できるのか?
    木下 真里菜 (日本女子大学), 宮田 侑佳 (日本女子大学大学院), 土田 悠佳 (日本女子大学大学院), 倉光 君郎 (日本女子大学)

  • [S3-P18] 動画生成モデルにおける直喩理解と喩体の生成挙動
    王 略丞 (東大), 尾崎 慎太郎 (NAIST), 上垣外 英剛 (NAIST), 林 克彦 (東大), Kwon Jingun (CNU), 奥村 学 (科学大), 渡辺 太郎 (NAIST)

  • [S3-P19] 表の幾何的構造に基づいた段階的プロンプト設計
    川波 稜 (Sansan), 白石 卓也 (Sansan), 竹長 慎太朗 (Sansan), 内田 奏 (Sansan)

  • [S3-P20] LLMによる経費精算ルールの自動適応
    王 悦綸 (マネーフォワード), 山岸 駿秀 (マネーフォワード), 貞光 九月 (マネーフォワード)

  • [S3-P21] 法規・規格文書の参照構造を考慮した知識グラフデータセットと構築基準の検討
    阿部 貴駿 (北大), 松藤 彰宏 (パナソニックエレクトリックワークス), 廣瀬 良文 (パナソニックエレクトリックワークス), 平山 大世 (北大), 坂地 泰紀 (北大), 野田 五十樹 (北大)

  • [S3-P22] 有機化合物の構造情報および知識情報の埋め込み相互変換に基づく分子生成モデルの開発
    坪井 一馬 (横国大理工), 松元 遊人 (横国大院理工), 小出 雄也 (横国大院理工), 五東 弘昭 (横国大院工)

  • [S3-P23] トークン単位のメモリを備えた離散拡散言語モデル
    樫森 信平 (豊田工大), 三輪 誠 (豊田工大)

  • [S3-P24] 層間共有による層位置に依存したFFNのパラメータ不均一配置アーキテクチャの効果検証
    池田 航 (東北大), 柴田 圭悟 (東北大), 矢野 一樹 (東北大), 高橋 良允 (東北大), 鈴木 潤 (東北大/理研/NII LLMC)

  • [S3-P25] 誹謗中傷文出力に対するJailbreakリスクに論理式プロンプトが与える影響の分析
    加藤 郁花 (横浜国大), 佐藤 心 (横浜国大), 石川 凌 (横浜国大), 野澤 遼太郎 (横浜国大), 高田 尚輝 (横浜国大), 森 辰則 (横浜国大)

  • [S3-P26] LLMの誤謬検知は不当な説得による判断変化を防ぐのか:誤謬検知の内部表現とベクトル介入
    上原 慧大 (横浜国大), 村山 太一 (横浜国大)

  • [S3-P27] チャットテンプレートの差異がLLMの性能評価に与える影響の統計的分析
    クェク ヨン シン (東北大), 種口 暁人 (東北大), 松田 陵佑 (東北大), 有川 透矢 (東北大), 松田 翔汰 (東北大), 池田 航 (東北大), 柴田 圭悟 (東北大), 津田 純花 (東北大), 齋藤 由佳 (東北大), 赤間 怜奈 (東北大/理研/国語研), 鈴木 潤 (東北大/理研/NII LLMC)

  • [S3-P28] 日本語対話環境におけるECエージェントの信頼性評価ベンチマーク
    二宮 大空 (CyberAgent)

  • [S3-P29] マルチターン対話の安全性は言語と文化のどちらに依存するのか?日本語と英語の比較研究
    五十里 渚 (早大), 福田 創 (早大), 高山 隼矢 (SB Intuitions), 綿岡 晃輝 (SB Intuitions), 河原 大輔 (早大)

  • [S3-P30] 有害カテゴリのマルチラベルデータセットの構築とカテゴリ間相互作用の分析
    北村 有彩 (一橋大), 佐藤 祥太 (一橋大), 小町 守 (一橋大), 鈴木 久美 (NII LLMC), 欅 惇志 (一橋大)

  • [S3-P31] LLMは邪馬台国論争の論文をどう評価するのか?
    前原 茜 (日本女子大), 森部 七海 (日本女子大), 西潟 優羽 (日本女子大), 倉光 君郎 (日本女子大)

  • [S3-P32] LLM内部表現における予測可能成分と新規成分の分析
    関口 正登 (電大), 前田 英作 (電大)

  • [S3-P33] 対数尤度で捉えるLLMの流行シグナル
    長井 夢歩 (日本女子大), 山下 果凛 (日本女子大), 長谷川 愛珠 (日本女子大), 西潟 優羽 (日本女子大), 倉光 君郎 (日本女子大)

  • [S3-P34] 音楽基盤モデルは音高情報を螺旋構造に埋め込む
    八木 颯斗 (慶大), 高道 慎之介 (慶大/東大), 佐藤 りん (早大), 田中 啓太郎 (早大), 森島 繁生 (早大)

  • [S3-P35] LLM推論における内部表現を用いたヒント妥当性の推定と選択的介入
    峯村 祥生 (東大), 浅野 輝 (東大), 馬場 雪乃 (東大)

  • [S3-P36] 単体複体を用いた言語モデルの出力空間の幾何的解釈
    石峯 拓海 (東大/国語研), 日野 英逸 (統数研/総研大), 横井 祥 (国語研/東北大学/理研/総研大)

  • [S3-P37] Benchmark Construction Pathways as Measurement Variables: A Controlled Khmer Case Study
    LOEM Mengsay (PFN), LAY Kimseng (東北大)

  • [S3-P38] パラメータ空間の幾何構造から見るタスク算術の失敗
    李 宰成 (総研大/国語研), 中石 海 (国語研/理研), 唐木田 亮 (国語研/理研/産総研/科学大), 横井 祥 (総研大/国語研/理研/東北大)

  • [S3-P39] 複数プロンプト型Consensus-GRPOによる機械翻訳
    田窪 真大 (愛媛大), 西田 祥人 (愛媛大), 二宮 崇 (愛媛大), 後藤 功雄 (愛媛大)

  • [S3-P40] 地方選挙におけるファクトチェック記事のソーシャルメディア上の拡散傾向の分析
    野田 陽 (朝日新聞社), 新妻 巧朗 (朝日新聞社), 田森 秀明 (朝日新聞社)

  • [S3-P41] 大規模言語モデルによる決算短信の評価と株価への情報織り込み分析
    河本 道弥 (JPSI), 多田 大 (JPSI), 源 怜維 (JPSI)

  • [S3-P42] LLMは話し言葉と書き言葉を何で区別しているのか ― BERT埋め込みと構成要件に基づく分析 ―
    森貞 堅湧 (新居浜高専), 田窪 洋介 (新居浜高専), 高品 良 (APTO), 狩野 洋一 (APTO), Jeongmyeong Lee (APTO)

  • [S3-P43] LLMによるインタビューにおける深堀り質問展開戦略の比較・評価
    土田 陸斗 (筑波大学), 園田 哲也 (筑波大学), 宇津呂 武仁 (筑波大学)

  • [S3-P44] DuplexChat:音声対話言語モデルのための大規模全二重音声対話コーパス
    中田 亘 (東大/産総研), 齋藤 佑樹 (東大/産総研), 猿渡 洋 (東大)

  • [S3-P45] 出来事に基づく認知症介護者の自然文感情予測におけるLLMの比較評価
    白川 桃子 (武蔵野大工), 佐々木 多希子 (武蔵野大工)

  • [S3-P46] Webエージェントのタスク遂行を阻害するWebサイト特性の帰納的分析
    山﨑 善啓 (NTT), 北条 伸克 (NTT), 鈴木 啓太 (NTT), 小篭 蒼 (NTT), 三浦 大和 (NTT), 西田 京介 (NTT)

  • [S3-P47] 音声合成モデルのパラメータ演算による任意話者の声質での方言合成 【デモあり】
    三森 俊祐 (SB Int/早大), 水本 智也 (SB Int), 藤田 雄介 (SB Int)

  • [S3-P48] nanochat-jp: 小規模日本語特化言語モデル統合研究基盤 【デモあり】
    工藤 慧音 (東北大/理研), 山口 健史 (理研), 坂口 慶祐 (東北大/理研)

  • [S3-P49] 性格付けされた対話システムを実現するための適応的ステアリングによる大規模言語モデルの応答制御
    山上 藍稀 (JAIST)

  • [S3-P50] LLMを用いた授業映像の翻訳 【デモあり】
    内田 和史 (筑波大), 山元 大地 (筑波大), 梶田 楓斗 (筑波大), 西村 信頼 (筑波大), 武藤 直輝 (山梨大), 宇津呂 武仁 (筑波大), レオ チーシャン (山梨大), 西崎 博光 (山梨大)

[18:30-20:00] ナイトセッション

所属や分野を超えて、縦と横のつながりを広げる交流の場です。立食形式で軽食を片手に、同世代の仲間と語り合い、憧れの研究者と直接話す機会を用意しています。

シンポジウム3日目: 8/18 (火) 仙台国際センター 展示室1・2

[9:30-10:00] 受付

[10:00-10:30] ハッカソン報告会

シンポジウム1日目に開催したハッカソンの報告会を行います。ハッカソンの内容のダイジェストを紹介し、優秀チームにご登壇いただいてチームの取り組みについてご発表いただきます。

[10:40-11:40] ポスターセッション (4)

  • [S4-P01] 事実検証ベンチマーク構築に向けた新聞訂正記事10年分の誤り分析
    山内 洋輝 (朝日新聞社), 田森 秀明 (朝日新聞社)

  • [S4-P02] 一般家庭における調理動画の安定収集を目的としたWebシステムの提案
    壁谷 宗汰 (愛工大), 徳久 良子 (愛工大/理研)

  • [S4-P03] インターネットラジオを用いた日本語諸方言音声コーパスの半自動構築
    中島 未唯 (慶大), 佐藤 なな子 (慶大), 高道 慎之介 (慶大/東大)

  • [S4-P04] 大規模言語モデルによる数学解説生成のための学習データセットの構築
    高須 弘政 (愛工大), 鳥巣 裕斗 (愛工大/NII LLMC), 徳久 良子 (愛工大/理研)

  • [S4-P05] 実コーパスと合成コーパスを用いたレジスタ別比喩出現率の検証
    上野 和樹 (甲南大), 永田 亮 (甲南大), 川崎 義史 (東大), 長谷部 陽一郎 (同志社大), 大谷 直輝 (東京外大), 高村 大也 (産総研)

  • [S4-P06] AnaToMを用いた大規模言語モデルの心の理論に関する詳細分析
    Lee JungHoon (電大), 前田 英作 (電大)

  • [S4-P07] Neural KWIC:KWIC 形式用例からの動的単語埋め込みの獲得と可視化
    島田 真緒 (一橋大), 木山 朔 (一橋大), 凌 志棟 (一橋大), 小町 守 (一橋大), 小木曽 智信 (国語研), 高村 大也 (産総研), 持橋 大地 (国語研/統数研)

  • [S4-P08] 大規模言語モデルを用いた相談型掲示板の回答意図推定
    羽鳥 なの香 (青学), 横山 暁 (青学)

  • [S4-P09] 依存構造木に基づく拡散言語モデルのマスク過程制御
    大畑 綾音 (豊田工大), 三輪 誠 (豊田工大)

  • [S4-P10] Tanka Diffusion ―拡散モデルによる短歌の自動生成―
    羽根田 賢和 (東北大), 坂口 慶祐 (東北大/理研)

  • [S4-P11] Low-Resource Burmese-to-Japanese Speech Translation with LLM-Generated Data and LLM-as-Judge
    KHINE ZAR THWE (奈良先端科学技術大学院大学(NAIST)), 大内 啓樹 (奈良先端科学技術大学院大学(NAIST)), Sakti Sakriani (奈良先端科学技術大学院大学(NAIST))

  • [S4-P12] 言語特異的ニューロンの抑制による学習フリーなクロスリンガル音声合成の品質改善
    増子 凱斗 (エクサウィザーズ), 和田 和浩 (エクサウィザーズ), 櫻井 大雅 (エクサウィザーズ)

  • [S4-P13] 4者の会話における会話特性の分析
    清水 周一郎 (慶應大), 高道 慎之介 (慶應大/東大)

  • [S4-P14] Code2Figure: 学術論文における実装コードに基づくモデル図生成の初期検討
    川田 拓朗 (法政大/ZOZO研究所), 守田 竜梧 (RPTU & DFKI), 清水 良太郎 (ZOZO研究所), 渡邉 洸 (RPTU & DFKI), 彌冨 仁 (法政大)

  • [S4-P15] Where Do Vision-Language Models Preserve and Use Depth Information?
    陳 冠帆 (法政大), 川田 拓朗 (法政大), 守田 竜梧 (RPTU & DFKI), 北田 俊輔 (法政大), 彌冨 仁 (法政大/法政大)

  • [S4-P16] ルビはVLMの日本語文書画像理解を助けるのか?
    米山 瑛人 (愛媛大), 梶原 智之 (愛媛大/大阪大)

  • [S4-P17] Grounding Word Senses in Vision: Multimodal Word Sense Induction
    金 熙洙 (一橋), 凌 志棟 (一橋), 木山 朔 (一橋), 小町 守 (一橋)

  • [S4-P18] 視覚言語モデルと病徴属性を用いた植物病害診断手法の検討
    須藤 水基 (法政大), 畔上 達希 (法政大), 川田 拓朗 (法政大), 彌冨 仁 (法政大/法政大)

  • [S4-P19] MLLMのマルチターン対話における画像・テキスト情報統合能力の評価
    中尾 圭佑 (早大/NII LLMC), 栗田 修平 (NII/NII LLMC), 河原 大輔 (早大/NII LLMC)

  • [S4-P20] LLMへのESG開示関連情報の付与はESGレポートのコンプライアンスチェックに役立つか?
    解良 智紀 (一橋大), 関 洋平 (筑波大), 中尾 悠利子 (関大), 高村 大也 (産総研), 欅 惇志 (一橋大)

  • [S4-P21] オンライン掲示板からの医薬品副作用・不適正使用情報の抽出
    萩原 茂親 (NAIST), 戴 寧 (NAIST), 西山 智弘 (NAIST), 若宮 翔子 (NAIST), 荒牧 英治 (NAIST)

  • [S4-P22] 自然言語タスク指示に基づく信号時相論理仕様を用いた自律移動ロボットの制御
    芹澤 和伸 (阪大), 橋本 和宗 (阪大)

  • [S4-P23] 部分空間に制約したCMA-ESによるLLMの事後学習の初期検討
    久保田 健太 (北大), 藤後 廉 (北大), 前田 圭介 (北大), 小川 貴弘 (北大), 長谷山 美紀 (北大)

  • [S4-P24] Leveraging the multi-script Japanese writing system to apply the SpaceByte architecture
    波山 慎子 (奈女大), 須藤 克仁 (奈女大)

  • [S4-P25] コンテキスト設計でLLM脆弱性診断は向上するか?
    長谷川 愛珠 (本女), 森部 七海 (本女), 山下 果凜 (本女), 倉光 君郎 (本女)

  • [S4-P26] 多言語LLMの政治的回答分布は国別意見分布と一致するかーCSESを用いた比較分析ー
    植田 雄士 (奈良先端大), 上田 健太郎 (奈良先端大), 鳥海 不二夫 (東大), 荒川 豊 (九大), 安本 慶一 (奈良先端大), 諏訪 博彦 (奈良先端大)

  • [S4-P27] LLMの日本語音象徴理解を測るベンチマーク構築にむけた検討
    三浦 秀隆 (慶大), 深尾 貫太 (慶大), 清水 周一郎 (慶大), 高道 慎之介 (慶大/東大)

  • [S4-P28] 日本の有権者ペルソナからLLMが生成する友人ネットワークの検証
    高柳 慶太郎 (京大), 廣中 詩織 (京大), 首藤 一幸 (京大)

  • [S4-P29] LLMは「日本語のゆれ」に対する日本語話者の容認度を再現するか
    高山 隼矢 (SB Intuitions)

  • [S4-P30] 画像生成AIにおけるキャラクター著作権侵害リスクのプロンプト・モデル・評価者別分析
    目時 大暉 (横浜市大/NII/LLMC), 森 友亮 (東大), 関根 聡 (NII/LLMC)

  • [S4-P31] 多言語LLMにおける知識想起は言語非依存の潜在空間で行われるか
    手塚 陽大 (JAIST), 北島 祥平 (JAIST), 大西 直 (JAIST/松尾研究所), 井之上 直也 (JAIST/理研)

  • [S4-P32] 大規模言語モデルにおけるモデル内知識の論理整合性の診断的評価
    北島 祥平 (JAIST), 井之上 直也 (JAIST), 手塚 陽大 (JAIST), 大西 直 (JAIST/松尾研究所)

  • [S4-P33] 大規模言語モデルにおける文内Attentionメカニズムの分析
    鴨田 豪 (総研大/国語研), 窪田 悠介 (総研大/国語研), 横井 祥 (総研大/国語研/東北大/理研)

  • [S4-P34] 推論型LLMの事後学習におけるタスク間干渉の解明
    宇野 真弘 (科学大), 馬 尤咪 (科学大), 岡崎 直観 (科学大/産総研/LLM研究開発センター)

  • [S4-P35] Feed-Forward Network への介入が長回答生成に与える影響
    村田 圭翼 (一橋大), 山田 寛章 (都立大), 欅 惇志 (一橋大)

  • [S4-P36] SASB項目一致事例を用いたFew-shot推論の効果検証
    趙 駿鵬 (シェルパ), 遠藤 一護 (シェルパ), 神田 峻介 (シェルパ), 楢木 悠士 (シェルパ), 赤部 晃一 (シェルパ), 小田 悠介 (シェルパ/情報研)

  • [S4-P37] 大規模言語モデルにおける低資源言語の内部表現分離
    李 辰仁 (東大), 大関 洋平 (東大)

  • [S4-P38] plamo-3-translate: 翻訳特化LLMの開発
    鈴木 海渡 (PFN), 今城 健太郎 (PFN)

  • [S4-P39] ニュース記事に対する読者感情分布の推定に向けて
    山口 哲平 (愛媛大), 花房 健太郎 (愛媛大), 近藤 里咲 (愛媛大), 梶原 智之 (愛媛大/阪大), 早志 英朗 (阪大), 中島 悠太 (阪大), 長原 一 (阪大)

  • [S4-P40] コモングラウンドを用いた対話的協働におけるすれ違いの可視化と修復
    嶌根 伸一 (科学大), 吉野 幸一郎 (科学大/阪大), 荒瀬 由紀 (科学大), 佐藤 拓真 (奈良先端大)

  • [S4-P41] 対話における登場人物の感情の理解と活用に向けて
    小山 将生 (愛媛大), 近藤 里咲 (愛媛大), 高山 隼矢 (愛媛大), 梶原 智之 (愛媛大/阪大)

  • [S4-P42] 発話と応答の感情を独立に考慮した共感自由対話システムの構築
    山本 聖留 (JAIST), 白井 清昭 (JAIST)

  • [S4-P43] タスク指向対話におけるLLMエージェントの「気遣い」の能力を測るベンチマークの構築
    勝見 久央 (NTT/阪大), 吉野 幸一郎 (阪大), 水上 雅博 (NTT), 西田 京介 (NTT)

  • [S4-P44] Toward a Japanese Office-Task Agent Benchmark: A Preliminary Localization of OdysseyBench
    Su Myat Noe (特任研究員, 国立情報学研究所 大規模言語モデル研究開発センター), 功太 中山 (特任研究員, 国立情報学研究所 大規模言語モデル研究開発センター), Yunang Wu (特任研究員, 国立情報学研究所 大規模言語モデル研究開発センター)

  • [S4-P45] AIエージェントが生成するアイデア系統樹の構造分析
    野首 優斗 (研究開発部)

  • [S4-P46] LLMによるペルソナ駆動型移動シミュレーション:多様な身体・心理的制約下での意思決定のための満足度評価
    遠藤 純音 (奈良先端大), 久田 祥平 (奈良先端大), 荒牧 英治 (奈良先端大), 若宮 翔子 (奈良先端大)

  • [S4-P47] 事前学習コーパスの栄養成分表示 【デモあり】
    源 怜維 (早大/LLMC), 藤田 一颯 (早大/LLMC), 清丸 寛一 (LLMC), 小田 悠介 (LLMC), 児玉 貴志 (LLMC), 河原 大輔 (早大/LLMC)

  • [S4-P48] 牛舎内音声を用いた教師なし異常検知手法の検討 【デモあり】
    寺尾 瑠真 (愛県大), 坪倉 和哉 (愛県大), 神谷 咲月 (農総試), 小島 秀介 (農総試), 兒嶋 朋貴 (農研機構), 入部 百合絵 (愛県大)

  • [S4-P49] LLM-as-a-Judgeを用いた金融ニュース因果関係説明生成の評価 【デモあり】
    謝 宇程 (筑波大), 小齋 友里菜 (筑波大), 土田 陸斗 (筑波大), 宇津呂 武仁 (筑波大)

  • [S4-P50] 誤情報拡散防止のためのコミュニティノート作成理由生成タスクの提案 【デモあり】
    田口 雄大 (筑波大学), 山本 勇太 (筑波大学), 嶋津 瑛 (筑波大学), 王 婧薇 (筑波大学), 宇津呂 武仁 (筑波大学)

[11:40-13:20] 昼休憩

[13:20-14:20] ポスターセッション (5)

  • [S5-P01] 対話(たいわ)におけるLLMの漢字(かんじ)読(よ)み能⼒(のうりょく)の評価(ひょうか)
    青野 広太郎 (SB Int), 髙山 隼矢 (SB Int)

  • [S5-P02] 元データの評価観点を保持した制御可能なQAデータ拡張
    小島 亮 (豊田工大), 三輪 誠 (豊田工大)

  • [S5-P03] 多角的なアノテーター間依存を考慮した観点別ラベル推定の効率化
    小林 稜馬 (北大), 李 吉屹 (北大)

  • [S5-P04] 機密情報検知を目的とした日本語NERスキーマの提案とデータセットの構築
    髙橋 遼 (Acompany), 小林 滉河 (Acompany), 平岡 拓海 (Acompany)

  • [S5-P05] 単語の共起行列の非負値因子行列分解による意味変化の分析
    木山 朔 (一橋大), 相田 太一 (一橋大), 小町 守 (一橋大), 小木曽 智信 (国語研), 高村 大也 (産総研), 持橋 大地 (国語研/統数研)

  • [S5-P06] サプライザルは表記選好と逆相関する
    山口 美咲 (東大), 三田 雅人 (東大), 磯野 真之介 (国語研), 大関 洋平 (東大/NII)

  • [S5-P07] 「掻痒」は「そう痒」より伝わるのか? ―医療用語における漢字表記の理解可能性の検討―
    倉本 真菜 (奈良先端大), 永井 宥之 (奈良先端大), 西山 智弘 (奈良先端大), 若宮 翔子 (奈良先端大), 荒牧 英治 (奈良先端大)

  • [S5-P08] 大規模言語モデルの埋め込みノルムに基づく連続的な文難易度制御に向けて
    野々村 奏 (愛媛大), 梶原 智之 (愛媛大/阪大), 荒瀬 由紀 (科学大)

  • [S5-P09] 拡散言語モデルの社会的バイアスに与えるサンプリング設定の影響
    齋藤 幸史郎 (科学大), 大葉 大輔 (科学大), Bollegala Danushka (UoL), 岡崎 直観 (科学大/産総研/NII LLMC)

  • [S5-P10] Diagnosing Dialect Bias in Whisper ASR across Korean and Mandarin
    LIM DONGHUI (科学大/Hanyang Univ.), 岡崎 直観 (科学大), 馬 尤咪 (科学大)

  • [S5-P11] Speech-Text-to-Text対話モデルにおける速度と精度のトレードオフ
    中畔 彪雅 (奈良先端大/理研/阪大), 吉野 幸一郎 (理研/阪大)

  • [S5-P12] Full-duplex音声対話システムの雑音頑健性評価
    中野 隼輔 (東大), 中田 亘 (東大), 齋藤 佑樹 (東大), 猿渡 洋 (東大)

  • [S5-P13] 発声に基づく動的な音響特徴量融合による音声感情認識
    清水 信希 (愛媛大), 濱本 惇之介 (愛媛大), 二宮 崇 (愛媛大), 後藤 功雄 (愛媛大)

  • [S5-P14] 視覚言語モデルを用いたAIエージェントによる悪質サイトの検知と警告能力の評価
    竹下 理斗 (法政), 川田 拓朗 (法政), 彌冨 仁 (法政)

  • [S5-P15] 「もったり」から「こんがり」まで、調理を感覚語で実況する
    小酒井 健真 (愛工大), 徳久 良子 (愛工大/理研)

  • [S5-P16] 画像サイズ変換を用いた視覚言語モデルに対する敵対的攻撃検出
    付 宇軒 (早大), 王 昊 (早大), 何 金松 (早大), 河原 大輔 (早大)

  • [S5-P17] 農業文書中の栽培暦を対象とした補助線描画による視覚質問応答の改善の試み
    中川 菫 (小樽商大), 木村 泰知 (小樽商大)

  • [S5-P18] 文書VQAにおける画像拡大ツールを用いた推論の性能・コスト分析
    楢木 悠士 (シェルパ), 赤部 晃一 (シェルパ), 中山 功太 (NII-LLMC), 小田 悠介 (シェルパ/NII-LLMC)

  • [S5-P19] 系列生成による古典籍くずし字認識
    小倉 甲陽 (東大), 林 克彦 (東大)

  • [S5-P20] 連続プロンプトチューニングを活用したキャラクター模倣音声対話システムの構築
    金子 拓正 (電通大), 稲葉 通将 (電通大)

  • [S5-P21] Knowledge Homophilyに基づく近傍知識を用いた介入がロングテール知識の想起に与える影響の分析
    板井 孝樹 (SB Intuitions), 奥山 陽平 (SB Intuitions), 平子 潤 (SB Intuitions), 廣淵 亮太 (SB Intuitions)

  • [S5-P22] 進化戦略によるLLM最適化における破滅的忘却の抑制:GRPO由来パラメータマスクの導入
    福田 創 (早大), 河原 大輔 (早大)

  • [S5-P23] SNS等のUI画像がVLMによる生成文の文体に与える影響
    片岡 純弥 (早稲田大), 小橋 洋平 (東大)

  • [S5-P24] 損失曲面のSharpnessに着目した継続SFT初期値の探索
    杉本 陽大 (東北大), 矢野 一樹 (東北大), 鈴木 潤 (東北大/理研/NII LLMC)

  • [S5-P25] 税理士試験とフロンティアモデル
    小野 克樹 (VAIABLE), 佐原 恭平 (VAIABLE/京大), 貞光 九月 (VAIABLE)

  • [S5-P26] 文化的に潜在化したメンタルヘルスリスクに対するLLM応答の安全性評価ベンチマークの構築
    嵐 大樹 (奈良医大), 久田 祥平 (NAIST), 折茂 圭介 (Ubie), 太田 満久 (Ubie), 風間 正弘 (Ubie), 五十嵐 健史 (Ubie), 荒牧 英治 (NAIST)

  • [S5-P27] 年代別評価データにおける大規模言語モデルの性能差の検出力分析
    有川 透矢 (東北大), 池田 航 (東北大), 齋藤 由佳 (東北大), 松田 翔汰 (東北大), クェク ヨン シン (東北大), 柴田 圭悟 (東北大), 種口 暁人 (東北大), 津田 純花 (東北大), 松田 陵佑 (東北大), 赤間 怜奈 (東北大/理研/国語研), 鈴木 潤 (東北大/理研/NII LLMC)

  • [S5-P28] パーソナライズベンチマークの「正答」は何に支えられているか:判断の根拠を統制するベンチマークの設計
    須貝 優太 (横国大), 村山 太一 (横国大)

  • [S5-P29] RAGを用いた知識補完による暗黙的ヘイトスピーチ検出手法の検討
    小林 秀太郎 (科学大), 荒瀬 由紀 (科学大)

  • [S5-P30] LLMが回答を決める早さはバイアスの現れやすさと関係するか?
    安里 優真 (北陸先端大), 小田 康平 (北陸先端大), 白井 清昭 (北陸先端大), Kertkeidkachorn Natthawut (北陸先端大)

  • [S5-P31] LLM-as-a-Judgeにおける絶対評価と相対評価の整合性はスコア帯でどのように変わるか?
    山下 伊織 (一橋大), 木山 朔 (一橋大), 伊藤 大陽 (一橋大), 小町 守 (一橋大)

  • [S5-P32] 対数尤度から測るドメイン間の「高低差」は何のシグナルか?
    菊池 美咲 (日本女子大学), 山下 果凛 (日本女子大学大学院), 長谷川 愛珠 (日本女子大学大学院)

  • [S5-P33] 構文文法に基づく言語モデルの構文獲得メカニズムの分析
    九門 涼真 (東大/理研), 谷中 瞳 (東大/理研/東北大)

  • [S5-P34] 非頻出subjectに対するLLMの知識編集では局所性が改善するのか ―subjectのトークン化傾向に着目した分析―
    豊嶋 勇伍 (電大), 前田 英作 (電大)

  • [S5-P35] 形容詞が導く文化バイアス
    福井 優那 (金大), 平尾 努 (金大), 高村 大也 (産総研)

  • [S5-P36] 文学テキストのスパースオートエンコーダ特徴の観察:Gemma Scopeシリーズからゲーテ作品を視る
    浅間 香織 (東大)

  • [S5-P37] 不均一な公開LoRAプールにおける学習なしルーティング
    和田 和浩 (エクサウィザーズ)

  • [S5-P38] 医療ドメイン文書からの教師なし時間関係グラフ生成
    田村 聡信 (科学大), 荒瀬 由紀 (科学大)

  • [S5-P39] 機械翻訳タスクにおける日本語文書単位容認性判断データセット構築と途中補完モデル
    松田 陵佑 (東北大), 工藤 慧音 (東北大/理研), 藤井 諒 (東北大/フューチャー), 伊藤 拓海 (東北大/MLS Inc.), 森下 睦 (東北大/フューチャー), 鈴木 潤 (東北大/理研)

  • [S5-P40] LLMによる属性・行動の関連付けに基づくユーザーベクトル生成 ―日経電子版を対象として―
    田村 匠 (日経), 酒井 優行 (日経), 大島 拓人 (日経)

  • [S5-P41] キャラクター発話文埋め込みの意味とスタイルの分離に向けて
    近藤 里咲 (愛媛大), 梶原 智之 (愛媛大/阪大)

  • [S5-P42] 対話中の感情変化と既存評価尺度の関係分析
    沼屋 征海 (東北大), 佐藤 志貴 (東北大), 守屋 彰二 (東北大), 藤井 諒 (東北大/フューチャー), 鈴木 潤 (東北大/理研/NII LLMC), 赤間 怜奈 (東北大/理研/国語研)

  • [S5-P43] 個人差を考慮した対話ドメインにおける話者の主観的評価の推定
    三浦 拓人 (JAIST), 白井 清昭 (JAIST)

  • [S5-P44] 自動運転制御のためのAIエージェント
    宮岡 佑弥 (慶大), 井上 正樹 (慶大)
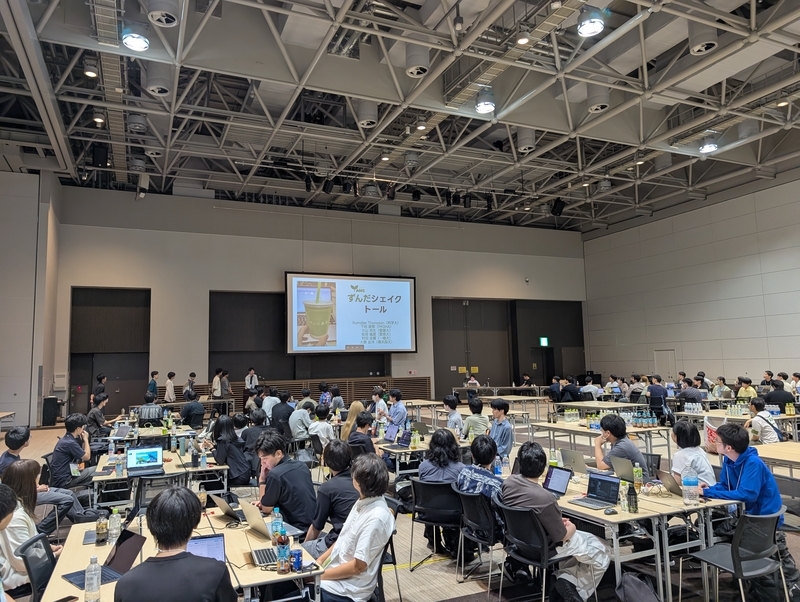
  • [S5-P45] 誤情報拡散防止のためのコミュニティノート収集およびデータセット作成 【デモあり】
    山本 勇太 (筑波大), 田口 雄大 (筑波大), 嶋津 瑛 (筑波大), 王 婧薇 (筑波大), 宇津呂 武仁 (筑波大)
  • [S5-P46] 学習済みモデルを用いたAI人狼ゲームの発言タイミングの評価 【デモあり】
    加藤 もも香 (愛県大), 鈴木 丈慈 (愛県大), 大橋 玲音 (愛県大), 坪倉 和哉 (愛県大), 小林 邦和 (愛県大)
  • [S5-P47] 待つか、聞き返すか:日本語日常会話における修復開始タイミングのモデル化 行旨 王我 (京都工繊大), 延原 章平 (京都工繊大), 河野 誠也 (京都工繊大)

  • [S5-P48] 麻雀AIの生成解説における盤面事実への忠実性と多事実列挙の限界分析 【デモあり】
    土田 蒼大 (N高/LLMATCH), 小橋 洋平 (LLMATCH/東京大学大学院工学系研究科)

  • [S5-P49] 画像を活用した英文ライティング支援システムの提案 【デモあり】
    宇野 和志 (愛工大), 永田 亮 (甲南大), 徳久 良子 (愛工大/理研)

[14:35-15:35] チュートリアル(2) 「言語モデルの70年:シャノンから大規模言語モデルへ」

講演者: 岡野原 大輔 氏 (株式会社Preferred Networks 共同創業者 代表取締役社長 / Matlantis株式会社 代表取締役社長)
概要: 言語モデルは、シャノンの時代には、言語を確率的な記号列として捉え、その冗長性や予測可能性を測ることが中心的な関心であった。その後、音声認識、機械翻訳、情報検索などの応用を背景に統計的言語モデルが発展し、さらにニューラルネットワークを用いた分散表現、系列モデル、Transformerへと大きく進化してきた。 近年の大規模言語モデルは、この長い流れの延長線上にありながらも、単なる文章生成器を超えた存在となり、対話、要約、翻訳、推論、コード生成、知識活用、ツール利用、さらにはエージェント的行動など、幅広い知的処理の基盤として利用されている。 本講演では、こうした歴史を振り返りながら、言語モデルの発展と活用の方向性について述べる。講演者は学生時代に言語モデルの研究に取り組み、その後もAIの研究開発と社会実装に携わってきた。現在は、大規模言語モデル PLaMo をはじめとする生成AIの研究開発に取り組んでいる。これらの経験を踏まえ、現在の言語モデルが抱える課題と、今後の展望について述べる。
略歴: 情報理工学博士。東京大学大学院在学中に、西川徹等とPreferred Infrastructureを創業。2014年にAIの実用化を加速するためPreferred Networksを創業。最高技術責任者として国産大規模言語モデルPLaMo™や汎用原子レベルシミュレータMatlantis™など、PFNの生成AIをはじめとするコア技術の研究開発および事業化をリード。2025年11月に社長に就任。Matlantisの代表取締役社長を兼任。受賞歴、著書多数。

[15:45-16:45] 招待ポスター

自然言語処理分野やその周辺領域で活躍されている研究者/技術者をお招きしして,ポスターセッションを開催します.学生や若手研究者に向けて,そのキャリアを選んだ理由やこれまでに達成した目標などを,現在取り組まれている研究開発と関連付けてお話いただく予定です.また,言語処理学会の留学支援を受けた方の留学報告も行う予定です.発表の概要、また発表者の略歴については以下のページをご参照下さい。
第21回言語処理若手シンポジウム(YANS2026) 招待ポスター詳細

[17:00-17:45] 特別企画セッション

多様な経歴を持つ若手・中堅の研究者・技術者が、これまでのキャリアにおける「分岐点」を振り返るパネルディスカッションを行います。進学、就職、転職、研究テーマの選択など、人生の節目で訪れたさまざまな転機に、それぞれがどう向き合ってきたのか。多彩な視点から語り合います。

登壇者(五十音順)

  • 勝又智 氏(株式会社レトリバ / 東京科学大学)

  • 坂井優介 氏(奈良先端科学技術大学院大学)

  • 三田雅人 氏(株式会社リクルート / 東京大学)

[17:45-18:45] クロージング

よくあるご質問

参加申し込みについて

Q:参加申し込みをしましたが当日参加ができなくなりました.参加費は返金されますか.

A:現地開催の中止やプログラムの変更など実施形態の変更が生じた場合でも,参加費の返金やその他にかかる費用の補償は一切いたしかねます.また参加登録者が保有する参加枠を他者に譲渡することも禁止しております.スポンサー招待枠についても同様に,スポンサー招待枠を他者に譲渡することは禁止いたします.同組織内であっても,参加登録をされた方ご自身がご参加ください.

Q:領収書はどこからダウンロードできますか.

A:領収書は参加登録システムの領収証発行セクションから2027年1月9日までダウンロードできます.

Q:発表日を参加可能な日に指定することはできますか.

A:原則として指定は不可となります.ただし,やむを得ない理由がある場合は運営にまでご連絡ください.

Q. 参加証はどこから入手できますか.

A:8月7日(金)に送付済みメールに,参加証印刷用のリンクが記載してあります.各自でカラー印刷して会場にお持ちください.

当日の発表について

Q:発表当日体調が悪くなってしまいました.現地参加する必要はありますか.

A:体調や現地の状況に不安がある場合は,現地参加をお控えください.ただし,発表者の方は,運営に事情を連絡したうえで,運営の指示に従ってください.“No Show” とならないよう対応いたします.

表彰について

Q:クロージングに参加できなかった場合,副賞は後日もらえますか.

A:手続きの都合上,当日クロージングに参加されなかった方が奨励賞などを受賞した場合,副賞の配布は行いません.賞状のみを後日送付いたします.

旅費補助について

Q:領収書は必要ですか.

A:精算には,領収書の提出が必要です.宛名は「一般社団法人 言語処理学会」でお願いします.紛失時は例外なく精算ができませんので,必ずすべて取っておくようにしてください.

第21回言語処理若手シンポジウム(YANS2026)招待ポスター詳細

招待ポスター

このセッションでは,自然言語処理分野やその周辺領域で活躍されている研究者/技術者をお招きして,ポスター発表形式でお話しいただきます.今年のテーマである「若手のその先へ」を促進するため,学生や若手研究者に向けて,そのキャリアを選んだ理由やこれまでに達成した目標などを,現在取り組まれている研究開発と関連付けてご紹介いただく予定です.また,このセッションでは言語処理学会の留学支援制度で留学された方に,ご自身の留学経験をお話しいただきます.研究の議論を交わしたい方,キャリア・進学等のご相談がある方など,多くの方のご参加をお待ちしております.

※講演者の追加・変更などありましたら,改めて告知いたします.
※掲載順は講演者名の五十音順です


「計算言語学者としてなぜ言語創発に取り組むのか?これからどうしたいのか?」
  上田 亮氏(国立情報学研究所)

上田 亮

概要: これまで、エージェント同士のコミュニケーションの中で生じる人工的な言語(創発言語)を観察・分析する「言語創発」という研究テーマに取り組んできました。なぜ言語創発という研究テーマに取り組んでいるのか、博士号取得後なぜ現在の職に就いたのか、今後どう在りたいのか、何を成し遂げたいのかについての身の上話をさせていただく予定です。皆さんの今後の選択に少しでも役立てば幸いです。

略歴: 2023年3月に東京大学大学院情報理工学系研究科コンピュータ科学専攻の修士課程を修了。2026年3月に同大学院にて博士課程を修了し、博士(情報理工学)を取得。2026年4月より国立情報学研究所(NII)情報学プリンシプル研究系助教に着任。計算言語学を専門とし、特に言語創発(Language Emergence)や創発コミュニケーション(Emergent Communication)といった分野に取り組む。


「地図と言葉のクロニクル」
  大内 啓樹氏(奈良先端科学技術大学院大学)

大内 啓樹

概要: 「今、大正時代の資料をAIで研究しています」と恩師に言ったら,「年を取ると歴史に興味を持ち始めるんだ」と言われた.恩師の経験則がどこまで一般化できるかは疑問だが,思い当たる節もいくらかある.構文・意味解析に明け暮れた学生時代を経て,言葉は場所へ,場所は歴史へと,少しずつ関心を広げてきた.本発表では,地理空間と歴史時間に言葉を接続する研究について,これまでの成果をたどり,今後の課題と展望を示す.

略歴: 奈良先端科学技術大学院大学准教授.2018年同博士後期課程修了.博士(工学).2021年より理化学研究所AIPセンター客員研究員.2024年より株式会社サイバーエージェントAI Labリサーチサイエンティスト(クロスアポイントメント).2024年より現職.


「物語をつくる・届ける企業でAIエンジニアができること」
  大竹 孝樹氏(株式会社講談社)

大竹 孝樹

概要: 小説やマンガ、雑誌、学術書──。総合出版社にはこれまでの歴史の中で人の感情や知識が表現された大量のコンテンツが蓄積されています。出版社は技術とは縁遠いイメージがあるかもしれません。しかし、こうした大量のコンテンツデータを活用することによって大きなインパクトを創出できる可能性があり、近年データと機械学習技術の活用を加速させています。本発表では総合出版社における研究開発の一例をご紹介し、ドメイン特有の面白さや課題について議論します。また、民話を対象としたNLPの研究に端を発し、物語への興味を軸としてキャリアを模索している著者のこれまでの振り返りをご紹介します。

略歴: 2021年東北大学大学院情報科学研究科博士前期課程修了。同年株式会社 Gunosy に入社し、機械学習エンジニアとしてニュース推薦モデルの開発等に従事。2024年株式会社講談社に入社。コンテンツデータを利用したプロダクトの開発に従事。


「言語モデルがAGIの基盤になるなんて」
  賀澤 秀人氏(Google DeepMind)

賀澤 秀人

概要: 現在のAIの基盤はLLMである。その発展のスピードは目を見張るばかりだが、より驚くべきは、作り方はわかっているのにどうしてこんな素晴らしいことが起きるのかが誰も理解できていない状況、そして、それにも関わらず技術が発展していくという状況だと考える。極端に言えば、科学の時代から錬金術の時代に戻ったかのような感覚すらある。こうした時代に科学的に研究や開発を進めることには独自のチャレンジとチャンスがある。本発表では、自身の経験にもとづいて、このユニークな時代をいかに生き抜いていくかについて考察したい。なお技術的な話は皆無である。

略歴: 修士課程で物理を学んだのち1997年に就職し、NTTコミュニケーション科学基礎研究所で(deep learning 以前の)AI、NLP、機械学習の研究に従事。2006年に Google 入社。Web検索・機械翻訳の技術開発をおこなったのち、2024年より Google DeepMind で Gemini の研究開発に従事。2020-2023 言語処理学会理事を担当。博士(工学)


「言語処理学会年次大会の歩き方 – 参加者兼企画者として」
  金山 博氏(日本アイ・ビー・エム株式会社 東京基礎研究所)

金山 博

概要: 学部4年の頃、言語処理学会第4回年次大会(NLP1998)で発表デビューをして以来、NLP2011以降は今年も含め16年連続で様々なテーマで発表を続けています。また、言語処理学会の理事を務め、NLP2020の大会副委員長、NLP2021の大会委員長(不運にもパンデミックの時期・・・)、NLP2023のプログラム編成マネージャを担当しました。自身が発表・聴講し、多くの人と出会えた場所として、継続・発展させていこうと活動してきた経緯と、そこから得た学びを共有します。YANS世代の皆さんが楽しく末永く活躍していくためのヒントを持ち帰っていただければ幸いです。

略歴: 2000年より日本アイ・ビー・エム株式会社東京基礎研究所に勤務し、現在は主席研究員。構文解析・意味解析など自然言語処理の基礎技術および、評判分析や知識抽出などの応用に関する研究に従事してきた。近年は、多言語モデルの評価やデータ生成に取り組んでいる。2011年に米国のクイズ番組で人間に勝利したWatsonプロジェクトに参画し、知識抽出を担当した。 また、2016年から2018年にかけて電子情報通信学会NLC研究専門委員長を務め、学術とビジネスを結びつける活動を推進した。2020年および2021年の言語処理学会年次大会では、副委員長および大会委員長として、パンデミック下での大会開催を成功に導いた。


「コードを介した文書画像の理解と生成」
  斉藤 いつみ氏(東北大学)

斉藤 いつみ

概要: 最近の画像生成モデルの発展により,ダイアグラムの生成など複雑な図の生成も性能が高まっている.一方で,画像を直接生成するモデルではダイアグラムの要素や文字の情報をシンボリックな情報として明示的に保持していない.本発表では,ベクター形式の画像生成を通じて,画像中の要素や文字などをシンボリックな情報として明示的に生成する手法について紹介する.

略歴: 2012年 東京大学大学院工学系研究科修士課程修了,2012年-2023年 日本電信電話株式会社 メディアインテリジェンス研究所・人間情報研究所,2020年 奈良先端科学技術大学院大学 博士後期課程修了,2023年〜現在 東北大学大学院 情報科学研究科 准教授,2025年9月〜現在 東京科学大学 情報理工学院 特任准教授

「バオバブとは何か」
  相良 美織氏(株式会社バオバブ)

相良 美織

概要: 大規模言語モデル(LLM)の急速な発展に伴い、その基盤となる「学習データの質」がこれまで以上に重要視されています。私たちバオバブは、多様なバックグラウンドを持つ国内外の作業者コミュニティと共に、長年にわたり高品質なアノテーションデータの創出に向き合ってきました。「良いデータ」とは単に仕様を満たすだけでなく、AIの性能を最大限に引き出し、社会実装を支えるための知恵の結晶です。本発表では、私たちが現場で培ってきたデータ品質管理のリアルな取り組みや、アノテーターの力を引き出す運用の工夫を紹介します。あわせて、データ領域の第一線で挑戦を続けるキャリアの面白さについてもお話しします。

略歴: 2010年に株式会社バオバブを創業。2011~2014年、独立行政法人情報通信研究機構に「わくわく創造担当」として勤務。音声認識技術を採用した障聴者と健聴者とのコミュニケーション支援アプリ「こえとら」の研究開発などに携わる。 バオバブは創業以来、機械翻訳エンジン用対訳、画像アノテーション・テキストアノテーション、マルチモーダル向けなど学習データ構築サービスを、Google、Carnegie Mellon UniversityやNTT東日本など日本/海外の法人・研究機関に提供。2013年、AAMT(Asia-Pacific Association for Machine Translation)長尾賞受賞。2015年、言語処理学会代議員就任。2017年、総務省情報通信審議会情報通信技術分科会技術戦略委員会次世代⼈⼯知能社会実装WG 構成員に就任。2024年 Forbes JAPAN テクノロジー領域で世界を変える女性30人受賞


「クリエイターを支える言語処理技術」
  佐藤 浩輔氏(株式会社バンダイナムコ研究所)

佐藤 浩輔

概要: 近年ゲームやアニメ、映画、漫画といったコンテンツが大規模化し領域横断的に展開するなかで、それらコンテンツに関わる知識をどのように管理運用するかが課題となっています。 コンテンツが大規模化するほど制作の際に前提・参照すべき知識は増大し、監修やチェックといった作業の負担も大きくなります。そこで求められるのがクリエイターにとって必要な情報にアクセスしやすくしたり、制作物の監修を手助けする技術です。 本講演ではこれまで私自身が携わった研究開発事例に触れつつ、「制作現場のニーズと『技術でできること』との間をどう埋めていくか」といった企業における研究開発業務の面白さや、「自身の専門性や能力を現場でどうやって役立てるか」といったキャリアに関する内容についてお話ししたいと思います。

略歴: 北海道大学大学院文学研究科博士後期課程単位取得退学。専攻は社会心理学。 2017年から明治大学 研究・知財戦略機構 研究技術員として音楽発掘サービス「Kiite」基幹部分の設計・開発・運用に従事。 2021年より株式会社バンダイナムコ研究所にて現職。エンターテイメント分野における研究開発に取り組む。


「NLPから専門領域AIへの展開」
  進藤 裕之氏(MatBrain株式会社)

進藤 裕之

概要: 自然言語処理では、表現学習、Transformer、LLMの発展により、機械翻訳や構文解析など個別に研究されていた多くの課題が汎用モデルの中に取り込まれ、研究の重心は個別課題向けのモデルやアルゴリズムの設計から、汎用モデルの構築・活用を通じて多様な課題を解決する研究へと移りました。本発表では、こうした技術変遷を振り返るとともに、企業、大学、起業における研究・開発経験を通じて、個々の研究課題を深く追究することと、研究分野全体を変える技術的潮流を理解することの重要性について考えます。また、近年取り組んでいる化学・材料や教育などの専門領域とAIを組み合わせた研究事例を紹介し、次の技術的潮流をどのように捉え、その変化に適応していくべきかについて議論します。

略歴: 2013年奈良先端科学技術大学院大学情報科学研究科博士後期課程修了。工学博士。2014年より同大学院大学院助教、2021年より同大学院大学特任准教授。現在、MatBrain(株)代表取締役。自然言語処理および機械学習の研究に従事。


「博士課程ってどんなところ?:自由すぎる研究生活の楽しみ方」
  関 健太郎氏(東京大学)

関 健太郎

概要: 博士課程への進学を検討している皆さん、あるいは博士課程が少しだけ気になっている皆さん。本ポスターでは博士課程在籍中の立場から、博士進学というキャリア選択と、博士課程での研究生活について紹介します。博士課程は、自分で研究テーマを生み出し、時間をかけて掘り進め、時には大きく変えながら挑戦できる、自由で楽しい時間です。一方でその自由さは、何を研究し、どの方向へ進むのかを自分で悩み続ける、根源的な難しさでもあります。私自身、音声合成、音源分離、音響言語モデルなど、さまざまなテーマに挑戦してきました。その経験をもとに、博士課程を歩む一つの事例として、博士進学の魅力と難しさを共有します。

略歴: 2022年に東京大学工学部計数工学科を卒業.2024年に東京大学 大学院情報理工学系研究科 システム情報学専攻 修士課程を修了し,同年同博士課程に進学.現在,博士課程3年.修士(情報理工学).2024年より日本学術振興会(JSPS)特別研究員(DC1).修士課程では音声合成の研究に従事.博士課程より音源分離,音声対話,音声変換,音響言語モデルの研究に従事.


「ニューラル言語モデルとの歩み」
  高瀬 翔氏(サイバーエージェント)

高瀬 翔 概要: 大規模言語モデルの登場以前からニューラル言語モデルの研究に従事しており、モデルの表現力の拡張やパラメータ効率・学習時間に対する効率の向上、学習の安定性の向上などの研究に取り組んできました。本発表ではこれらの研究を振り返りつつ、研究開発における大規模言語モデルとの付き合い方について議論します。

略歴: 2017年東北大学大学院情報科学研究科博士後期課程修了.博士(情報科学).NTTコミュニケーション科学基礎研究所研究員,東京工業大学研究員,同助教を経て,2022年-2024年LINE株式会社、2024年-2025年SB Intuitions株式会社リサーチサイエンティスト、2025年より現職。ニューラル言語モデルに関する研究に従事。


「自動運転スタートアップでの挑戦 ― NLPからフィジカルAIへ」
  寺西 裕紀氏(Turing株式会社)

寺西 裕紀

概要: 研究者としてキャリアを考えるとき,「研究を深めること」と「社会で使われるものを作ること」の間で悩んだ経験のある人は少なくないだろう。私は国立の研究機関で自然言語処理分野の研究に取り組んだ後,現在は自動運転スタートアップで研究開発に従事している。本発表では,フィジカルAIの開発へと関心を広げた背景や,完全自動運転という未踏領域に挑戦する中で体感した研究と社会実装の循環について紹介する。また,実世界で動作するAIシステムの開発において,研究的な考え方がどのように活きているのかについても共有し,研究者のキャリアの多様性について議論したい。

略歴: 2020年、奈良先端科学技術大学院大学先端科学技術研究科博士後期課程修了。博士(工学)。同年、理化学研究所革新知能統合研究センター(AIP)特別研究員。2023年より奈良先端科学技術大学院大学客員助教を兼任。2025年、Turing株式会社にシニアリサーチャーとして入社。自動運転システムの研究開発に従事。


「国産LLMをなぜ作るのか〜一研究者の立場から〜」
  西田 光甫氏(NTT株式会社 人間情報研究所)

西田 光甫

概要: 私が所属するNTT研究所は国産LLMを開発しています。GPT, Llama, Qwen, Gemmaを代表とする高性能なLLMがある中で、なぜ国産LLMが必要なのでしょうか。そこには様々な肯定的・否定的意見があります。本発表では、一研究者の立場から、私個人がなぜ国産LLMの開発に尽力しているのか・どのように楽しんでいるのか(苦しんでいるのか)についてご紹介します。研究開発の実態にも触れながら、激動の時代にNLP研究者が何をするべきかについても議論できれば有り難く思います。

略歴: NTT株式会社 人間情報研究所 准特別研究員。2017年に東京大学情報理工学系研究科数理情報学専攻修士課程を修了し、NTT株式会社に入社。2024年に東京大学情報理工学系研究科電子情報学専攻で博士(情報理工学)を取得。自然言語処理・機械学習・大規模言語モデルの研究開発に従事。


「研究留学への不安を少しでも減らすために」
  芳賀 あかり氏(奈良先端科学技術大学院大学)

芳賀 あかり

概要: 本発表では、オランダ・フローニンゲン大学での約半年間の研究留学について、留学前の準備、現地での研究、生活の様子を紹介します。異なる研究文化の中での共同研究の経験や、海外研究者との繋がりを得た一方で、言語や生活環境の違いによる難しさもありました。そこで、安心して留学に臨むために準備したこと、日本人のいない環境で研究を進めるうえで言語の壁を乗り越えるために工夫したこと、留学を通じて得た学びや反省点を率直に共有します。研究留学に少しでも興味のある方が、一歩踏み出すための参考となれば幸いです。

略歴: 2022年、電気通信大学メディア情報学プログラム卒業。2024年、奈良先端科学技術大学院大学情報科学領域博士前期課程修了。同年より同大学博士後期課程に在籍。2025年2月から約半年間、オランダ・フローニンゲン大学に研究滞在。自然言語処理および計算言語学の研究に従事。


「ChatGPTが無かった時代の博士課程」
  平岡 達也氏(MBZUAI)

平岡 達也

概要: 2022年のChatGPT公開以降、生成AIは日常生活だけでなく、研究環境をも大きく変えました。調べ物、ブレインストーミング、コーディング、英文校正まで、AIと対話しながら研究することは当たり前になっています。かつて生成AIの利用に懐疑的だった私も、今では日常的にChatGPTを壁打ち相手として使っています。ふと周りを見渡すと、現在の修士・博士学生の研究環境も、私が博士課程を過ごした頃とは大きく異なっているように感じます。この機会にChatGPT以前の博士課程の研究環境を振り返りつつ、時代遅れになったかもしれない研究ノウハウと、今なお有効な研究の姿勢について整理し、皆さんと議論したいと思います。

略歴: 2019年にNAISTの修士課程を修了、2022年に東京工業大学博士課程を修了、博士(工学)。富士通株式会社にて博士研究員を経験した後、現在はMBZUAIにてPostdoctoral Associate。理研AIPにて客員研究員、NAISTにて客員助教を兼務。研究の興味は「機械学習モデルの目を通して見る自然言語の世界」。長く取り組んでいる研究テーマはTokenization、最近はLLMの内部機序解釈・メタ認知的制御にも取り組んでいる。


「狭くて広い,企業での研究活動」
  本多 右京氏(サイバーエージェント)

本多 右京

概要: 企業での研究活動について,どのようなイメージを持っているでしょうか?自分自身が学生だった頃を振り返ると,柔軟な予算に魅力を感じていた一方,研究テーマや対外発表機会の制約に不安を覚えていた記憶があります.本発表では,これまで取り組んできた研究の紹介を通して,企業での研究活動の実際とその幅広さの一例をお伝えします.この幅がもつメリット・デメリットにも触れ,自身の研究キャリア形成に企業研究所が適しているかどうかを考える一助になればと思います.

略歴: サイバーエージェント AI Labリサーチサイエンティスト.2023年 奈良先端科学技術大学院大学博士後期課程修了.博士(工学).


「好奇心のおもむくままに:アカデミアから企業へ、テキストから音声へ」
  水本 智也氏(SB Intuitions株式会社)

水本 智也

概要: 学生の頃に自然言語処理に出会い、大学、国の研究所、ITコンサル、事業会社など多くの場所での自然言語処理に関する研究開発をしてきた。現在は数せんだいのGPUがある環境で未だてさぐりのことも多い音声言語モデルの研究開発を行っている。長年テキストを扱ってきたが、実際の音声対話では、疑問文の語尾のイントネーションやしずんだ感情など、書き起こされたテキストでは抜け落ちてしまう豊かな言語的特徴が表出する。本ポスターでは、こうした「テキスト外の情報」を統合する現在の研究の面白さを紹介するとともに、みちのくうかんに飛び込んできた私のキャリアパスを振り返る。

略歴: SB Intuitions株式会社 シニアリサーチエンジニア。博士(工学)。2015年奈良先端科学技術大学院大学にて博士号取得。東北大学助教、理化学研究所AIP研究員を経て、2019年にフューチャー株式会社に入社しITコンサルタントとして実ビジネスへのNLP技術の応用に携わる。その後、LINE株式会社(現在のLINEヤフー株式会社)を経て、2024年より現職。専門は自然言語処理。LINE在籍時に対話コンペティションに参加し音声対話に携わる。その時の経験からSB Intuitions入社後はテキストの枠を超え、音声言語モデルの研究開発に注力している。2014〜2016年にはNLP若手の会プログラム委員も務めた。


「LLMは最強のラップバトルMCになり得るか?」
  三林 亮太氏(神戸大学 国際文化学研究科)

三林 亮太

概要: LLMは文章生成や対話生成において高い性能を示している一方で、ラップバトルのような即興の競技では、単なる文法的な正しさだけでなく、ライム、フロウ、さらには相手の発言を踏まえたアンサーやユーモアなど、多様な能力が瞬時に求められます。本講演では、ラップバトルを題材としたこれまでの研究を紹介しながら、「LLMは最強のラップバトルMCになり得るのか?」という問いについて考えます。さらに、「とりあえず博士課程に進んでみよう」と思った結果、気づけば大学教員2年目になっていた立場から、「博士課程って辛いの?」「アカデミアって実際どうなの?」といったテーマについてもお話しします。博士課程進学やアカデミアへの就職に興味がある方にも参考になる内容になれば幸いです。

略歴: 略歴: 2025年兵庫県立大学大学院情報科学研究科博士後期課程修了。博士(情報科学)。同年より神戸大学大学院国際文化学研究科助教。2022年度未踏IT人材発掘・育成事業スーパークリエータ。現在はラップバトル対話システム、押韻生成、大規模言語モデル(LLM)の評価・応用に関する研究に従事。


「君たちは対話システム界隈でどう生きていくか」
  吉田 快氏(株式会社IVRy)

吉田 快

概要: LLMの発展に伴いテキストを用いた対話システムの対話能力は飛躍的に向上した。 一方で自然な音声対話体験のためには多くの面で改善の余地が残されている。 本発表では、企業における開発と研究の両面から「対話システムの現時点の課題」を整理し、より実践的な音声対話システムに向けてどのような要素が必要とされているかを議論する。 さらに、大学院およびスタートアップで対話システムの研究開発に取り組んできた経験を踏まえ、産学双方の視点から違いを明確化し、対話に関するキャリア選択を議論する。

略歴: 2023 年NAIST中村研にて博士前期課程修了。2026年同大学院吉野研にて博士後期課程修了。大学院ではテキストベースの対話システムの評価および生成に関する研究に従事。同年より株式会社IVRyにて音声対話に関する研究開発を担当。博士(工学)。


「言語モデルと人間を比較・対照するということ」
  吉田 遼氏(東京大学)

吉田 遼

概要: 高性能な次単語確率推定器としての言語モデルを、人間の文処理の原理解明に利活用しようとする動きが盛んである。こうした研究の多くは、人間から計測される指標(読み時間や脳活動など)と、言語モデルから得られる量(サプライザルなど)とを比較・対照するという形をとる。さて、この比較・対照の営みは、両者を結びつける「橋渡し仮説(linking hypothesis)」により正当化されるものである。しかし、その橋渡し仮説が本来持つコミットメントや意味づけは、必ずしも十分に意識されているとは言いがたい。本発表では、こうした橋渡し仮説を再訪することで、言語モデルと人間を比較・対照する研究群が暗黙のうちに引き受けているコミットメントについて考えたい。

略歴: 東京大学大学院総合文化研究科言語情報科学専攻博士課程在学。2021年東京大学教養学部教養学科超域文化科学分科学際言語科学コース卒業、2023年同大学大学院総合文化研究科言語情報科学専攻修士課程修了。専門は計算(心理)言語学。特に、言語モデルを用いて人間のオンライン文処理の原理に迫る研究に取り組んでいる。栃木県小山市出身。


「マルチリンガルNLPの理想と現実」
  李 凌寒氏(Google DeepMind)

李 凌寒

概要: 英語を中心に発展してきたNLPを、他の言語でも同じ品質で使えるようにするには何が必要でしょうか。事前学習モデルが主流となった今、言語横断転移学習ですべてが解決すれば理想的です。しかし、現場で直面するのは、往々にしてデータの不足と、言語間で転移するものの限界です。本発表では、大学院での言語横断転移学習に関する研究から、企業での LLM 開発まで、これまでのキャリアを振り返りながら、マルチリンガルNLPの現在地についてお話しします。

略歴: Google DeepMind リサーチエンジニア。2023年、東京大学大学院情報理工学系研究科博士課程修了(鶴岡研究室)。LINE / LY Corporation / SB Intuitionsで日本語 LLM の開発に携わったのち、2025年11月より現職。現在は多言語音声 LLM の研究開発に取り組む。

第21回言語処理若手シンポジウム(YANS2026) 分野交流ハッカソン

重要日程

  • ハッカソン参加申込期間: YANS参加申込期間と同じです。
  • タスク概要の共有日: 開催1週間前を目安に参加者用Slackで配信
  • ハッカソン当日: シンポジウム1日目 13:30 – 19:30(受付開始時間は13:00)

ハッカソンの概要

シンポジウム1日目の8月16日(日)に分野交流ハッカソンを開催します。本ハッカソンは、自然言語処理分野の学生・若手研究者を中心に、分野横断的な交流と実践的な問題解決経験の提供を目的としています。

今年は、近年問題となっているcitation hallucination(引用ハルシネーション)をテーマに開催します。ルール設計や類似度計算、LLM活用などを組み合わせた手法の開発を通じて、実践的な自然言語処理の問題設定に取り組んでいただきます。

また、特別審査員(アドバイザ)として国語研の横井祥さん、SB Intuitionsの品川政太朗さん、Preferred Networksの今城健太郎さんの豪華三銃士をお招きします。ハッカソンの時間中は三銃士に質問することもできますので、この機会に交流してください。

学生・社会人問わず、ふるってご参加ください。自然言語処理の若手研究者はもちろん、普段は自然言語処理以外の分野でご活躍されている方や、これをきっかけに自然言語処理に触れてみたい、交流を広げたいといった方も大歓迎です。自然言語処理の経験が浅い方でも取り組めるよう、ベースライン手法やデータを提供します。また、ハッカソン・コンペなどに参加したことがない方でも大歓迎です。優秀チームには表彰もありますので、ぜひチャレンジしてください!

参加までの流れ

参加申し込み

YANS2026参加の発表・聴講参加申し込み時に、参加登録フォームにある「ハッカソン参加の有無」の項目で「はい、参加します」を選択してください。ハッカソン参加者数は定員がございますので、お早めにお申し込みください。

※ ハッカソンの参加に際して、追加で費用は発生いたしません。
※ ハッカソンを希望されない方は、「ハッカソン参加の有無」の項目で「いいえ、参加しません」を選択してください。
※ チーム編成は、参加者に対して事前に行うアンケートの回答を踏まえて運営側で実施します。事前にチームを組んだ上でのご参加はできません。

タスク概要の共有(ガイダンス)

ハッカソン開催日の1週間前ごろを目安に、参加者用Slackにてガイダンス用資料を配信します。それまでに参加者用Slackへ招待しますので、ご参加をお願いいたします。
また、ガイダンスの連絡の際に、テーマおよびチームの振り分けについても発表します。ハッカソン当日までに必ずご確認ください。

ハッカソン当日

ハッカソンはシンポジウム1日目の8月16日(日)の13:30から、オンサイトにて開催します。 受付開始は13:00です。

ハッカソンのタスク内容

本コンペは、誤りの可能性がある引用を含む文書を対象とした競技形式の取り組みです。各チームには、引用の妥当性判定を中心に、アルゴリズムの工夫やデータ分析によって、タスク性能の向上に挑戦していただきます。 具体的な課題内容は、ガイダンス時にご案内します。

各チームの取り組みをいくつかの観点で評価をして、以下の3種類の賞を授与する予定です。各賞を授与するチーム数などは、ハッカソン参加者の人数を踏まえて後日決定します。

  • 優秀賞: タスクの評価メトリックを用いて提出システムを評価し、スコアが高いチームに授与します。
  • 審査員特別賞: 手法の独創性・取り組み内容の発表の面白さなどを踏まえて特別審査員が評価します。
  • YANS 委員特別賞: 上記で挙げたもの含め総合的な観点からYANS 委員が評価します。

そのほかの注意点

以下の通りです。その他の詳細はガイダンスでお伝えします。

  • Google Colabを使用できる端末(ノートPC等)をお持ちください。
  • 各チームに対して生成AIサービスのAPIキーを提供します。
    • API利用にはUsage Limitを設けます。この範囲内でかかる費用は運営で負担します。この範囲を超えて自費で使うことは認めません。
    • 生成AIサービスはOpenAI APIの利用を想定していますが、その他サービスに変更する可能性もあります。

第21回言語処理若手シンポジウム(YANS2026) スポンサー一覧

スポンサーの募集についての詳細ページはこちら

第21回言語処理若手シンポジウム(YANS2026)は以下のスポンサーの皆様に協賛いただいております。

ダイヤモンドスポンサー

プラチナスポンサー

ゴールドスポンサー

シルバースポンサー